
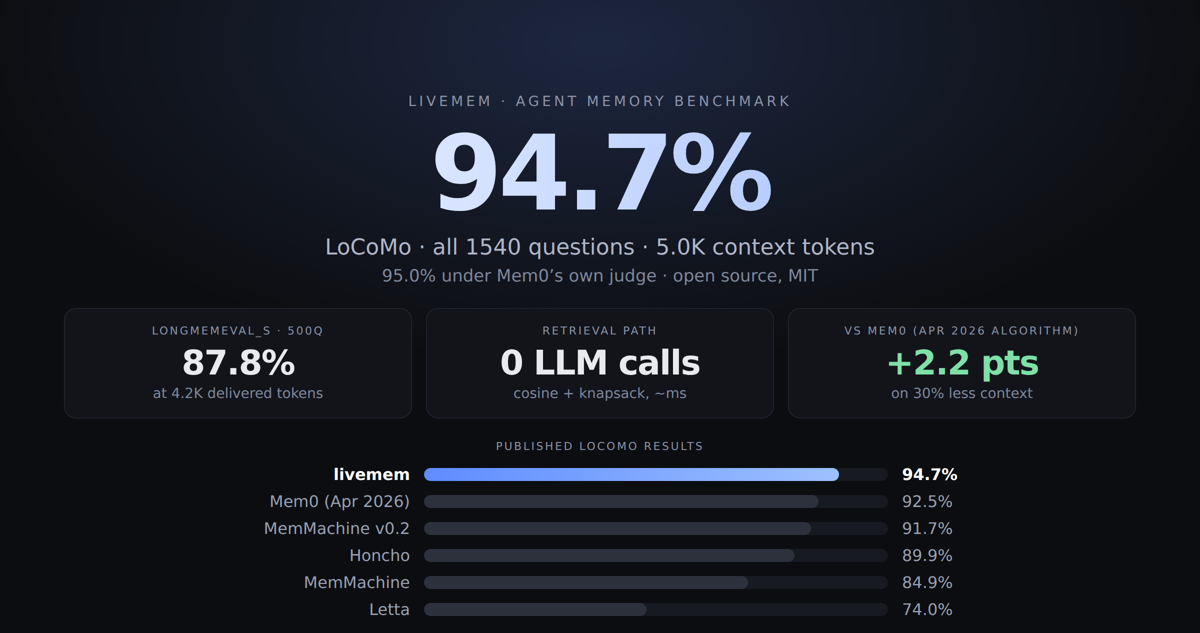
94.7% a LoCoMo-n 5.0K kontextus-tokennel — 95.0%, ha a Mem0 saját bírálója értékeli újra. A hasznosabb felfedezés az, amit útközben mértünk.
A szám, a konfigurációjával együtt
94.7% a LoCoMo-n, mind az 1540 kérdésen, kérdésenként 5.0K kontextus-tokennel. Ez a legmagasabb LoCoMo-szám, amiről tudunk, akár publikált, akár nem, és oda tudjuk adni hozzá a kódot meg a kérdésenkénti kimeneteket (github.com/todoforai/livemem).
A legközelebbi publikált sor a Mem0 2026. áprilisi algoritmusa: 92.5, átlagosan 6956 kontextus-tokennel; utána a MemMachine 91.7%-a a v0.2-re. Vagyis: +2.2 pont, nagyjából 30%-kal kevesebb kontextussal.
Kategóriánként: open-domain 97.0%, single-hop 93.6%, temporal 93.5%, multi-hop 81.2%. Az utolsónál van még munka, és inkább kiírjuk, mint hogy elmossuk az átlagban.
Mennyi ebből a bíráló? Ezt kérdeznénk mi is először, ezért megválaszoltuk: ugyanazt az 1540 választ újrabíráltuk gpt-4o-mini-vel, Mem0 saját ACCURACY_PROMPT-jával — ez az a bíráló modell és prompt, amely a publikált LoCoMo-számaik mögött áll — és 95.0%-ot kaptunk (+18 váltott helyesre, −13 a másik irányba). A két bíráló 0.3 ponton belül egyezik ezeken a válaszokon. Az előny nem a bírálás műterméke.
Mennyi ebből az ensemble? A válaszok ugyanazon a visszakeresett memórián futó két menetből jönnek: a gemini-flash és a claude-haiku-4-5 egymástól függetlenül válaszol ugyanarra az 5.0K-s blokkra, aztán egy szabályhierarchia (egyezés > vállalás > tartózkodás) dönt a 82 eltérésről. Egyetlen menet önmagában 92.4%-ot ér el. Tehát +2.3 pont a válaszoldalról jön, egy helyett két modellhívással és kérdésenként ~6 másodperccel — nem több kontextussal.
Ez a különbségtétel lesz az egész poszt témája.
És mielőtt más mondaná: a LoCoMo 94.7%-nál már majdnem telített benchmark. A Mem0 maga is ezt mondja — „a régebbi benchmarkok, mint a LoCoMo, ma kevésbé informatívak”, mert nem teszik próbára a rendszereket ellentmondó frissítésekkel, identitásbeli kétértelműséggel vagy hosszan futó munkafolyamatokkal. Egyetértünk, és mégis publikáljuk a sort, mert a telített benchmark pontosan az a rezsim, ahol a nem jelentett változók — válaszadó, bíráló, kontextuskeret — döntik el a sorrendet. Két pont mozgástér és egy hétpontos válaszadó-hatás nem ranglista; mérési probléma. A poszt hátralévő része erről a mérési problémáról szól.
A felállás
Mi csináljuk a TODOforAI nevű agentet, ami hosszan futó feladatokat futtat a gépeden. A hosszan futó itt azt jelenti, hogy emlékeznie kell: mit döntöttél három hete, mi a deploy-folyamatod, két ellentmondó utasítás közül melyik az újabb.
Úgyhogy építettünk egy memóriarendszert, aztán megtettük, amit ilyenkor kell: publikált számokhoz mértük, ahelyett hogy a saját demóinkban bíztunk volna.
Két nyilvános adathalmaz:
- LongMemEval_S — 500 kérdés hosszú, több munkamenetes chat-előzményekre. Egy munkameneten belüli felidézés, több munkamenetes aggregáció, időbeli következtetés, tudásfrissítések.
- LoCoMo — 1540 kérdés, több időbeli és multi-hop következtetéssel.
Mindkettő az AMB-n fut át, ami egy független harness: minden memóriaszolgáltatónál ugyanaz az adathalmaz, ugyanaz a válaszadó modell és ugyanaz a bíráló.
A LoCoMo korán jól ment. A LongMemEval volt a kijózanítóbb, és az is maradt: az első őszinte, teljes adathalmazos számunk 85.4% volt, szemben a Mem0 publikált 94.4%-ával. Ma 87.8%-on állunk — jobb, még mindig le vagyunk maradva, és ezt 4.2K kontextus-tokennel, az övék 6.8K ellenében, ami az összehasonlításnak az egyetlen része, aminek örülünk.
Ez a 9 pontos lemaradás indított el minket hibákat keresni, és a hibák érdekesebbnek bizonyultak, mint maga a szám. Ezért foglalkozik a poszt hátralévő része többet a LongMemEval-lel, mint azzal a benchmarkkal, amelyen vezetünk.
A hiba nyomában
A kézenfekvő hipotézis az, hogy az ő architektúrájuk jobb. Úgyhogy elkezdtük keresni, mit csinálunk rosszul, és találtunk valódi dolgokat:
A deduplikáció bizonyítékot törölt. Egy olyan kérdés, mint „hány növényt vettem a múlt hónapban?”, minden előfordulást igényel, nem csak a top-k leghasonlóbbat. A deduplikációnk összevonta a „2 bazsalikomnövényt vettem” és a „3 bazsalikomnövényt vettem” mondatokat — majdnem azonos mondatok —, és csendben megsemmisített egy előfordulást, amitől a számolás függött. Amikor számtudatossá tettük a deduplikációt (két tény, amelyben eltérő számjegyek vannak, sosem duplikátum, bármilyen hasonló is a szöveg), az +4.3 pontot ért egy 94 kérdéses validációs részhalmazon (78.7% → 83.0%).
A kinyerés túl válogatós volt. A promptunk kihagyta, amit „egy LLM amúgy is tud”. Aztán jött egy kérdés: „mi volt az a Borges-idézet, amit idéztél nekem?” — nyilvánosan hozzáférhető tudás, igen, de az a konkrét dolog, amit mi mondtunk abban a beszélgetésben, egyetlen modell súlyaiban sincs benne. A tanulság általánosítható: a kinyerésnek mohónak kell lennie, mert a ki nem nyert tényt sosem lehet visszakeresni. A válogatás a kiválasztó dolga, nem a kinyerőé. Ez három olyan kérdést javított a részhalmazunkon, amelyek addig megválaszolhatatlanok voltak.
Vannak válaszok, amelyek egyáltalán nem tényekben élnek. Egy beszélgetési fordulóban vannak, amit egyetlen összefoglaló sem őrzött meg. Olyan visszakeresési konfiguráció hozzáadása, amely az entitáskártyákat 3 fordulós beszélgetésablak-részletekkel keveri a lepárolt tények mellett, a teljes 500 kérdéses futást 85.4%-ról 87.8%-ra vitte.
Valódi javulások, valódi pontok. Még mindig nem 94.4%.
A változó, amit nem kontrolláltunk
Ezt az első napon kellett volna ellenőriznünk. Eddig a lehető legolcsóbb modellel válaszoltattunk — gemini-flash-lite —, szándékosan, a fenti okból.
A Mem0 publikált harness-konfigurációja gpt-5-öt használ válaszadónak és gpt-5-öt bírálónak.
Úgyhogy lefuttattuk a kontrollt: ugyanaz a memóriarendszer, ugyanazok a kinyert tények, ugyanaz a visszakeresés, ugyanaz a renderelt kontextus. Csak a válaszadó modellt cseréltük.
| Konfiguráció (94 kérdéses részhalmaz) | Pontosság |
|---|---|
| flash-lite válaszadó, flash-lite bíráló | 85.1% |
| gpt-5 válaszadó, flash-lite bíráló | 92.6% (+7.4) |
| gpt-5 válaszadó, gpt-5 bíráló, ugyanazok a válaszok újrabírálva | 90.4% (−2.2) |
+7.4 pont egyedül a válaszadótól. És a bíráló is szabad változó — bár vedd észre, hogy az erősebb bíráló szigorúbb volt, nem engedékenyebb: két olyan óvatosan megfogalmazott választ elfogadott, amelyre addig nem kaptunk pontot, és négyet elutasított, amelyre addig kaptunk.
Légy óvatos azzal, mit mutat ez és mit nem. Nem bizonyítja, hogy a Mem0 94.4%-a „valójában” alacsonyabb, és azt sem, hogy két rendszer közti különbség teljes egészében a válaszadó megválasztásából jön — az ő rendszerüket sosem futtattuk a mi harnessünkön. Amit mutat, az szűkebb, de hasznos: ugyanazon a memórián a publikált eredményeket elválasztó nagyságrendű konfigurációs különbségek nagyjából annyi pontot érnek, mint maga a memóriaarchitektúra. A saját, valamennyire összehasonlítható számunk 90.4%, ami még mindig kevesebb 94.4%-nál. Csak éppen már nem hisszük, hogy két eltérően konfigurált sor nyers távolsága bármit is mér.
Amit valójában tanultunk
1. A különböző harnessek memóriaszámai nem rangsort adnak. A legvilágosabb bizonyíték nem is a miénk: a publikált irodalomban a Mem0 94.4%-on szerepel (saját közlés) és 67.6%-on (egy harmadik fél tanulmányában mérve). Ugyanaz a rendszer, 27 pont eltérés, mert a harness, a válaszadó, a bíráló prompt és a keret különbözik. Minden táblázatot, amely forrásokat kever — beleértve a repónkban lévőt is —, külön konfigurált kísérletek gyűjteményeként kell olvasni, nem ranglistaként.
2. A bírálók pontokat érnek, nem tizedeket — és nem csak a promptjuk miatt. Az egymenetes válaszaink 92.4%-ot kaptak claude-haiku-4-5 alatt és 95.6%-ot gpt-4o-mini alatt, majdnem azonos bíráló promptokkal. A két szám között a memórián semmi sem változott; csak az, hogy melyik modell olvasta ugyanazt az értékelési utasítást. (Az ensemble válaszokon ugyanez a két bíráló 0.3 ponton belül van egymástól — a bíráló-hatás mérete maga is konfigurációfüggő, és épp ez a lényeg.)
3. A kontextusméret rejtett tengely. Mi ~4–5k token körül dolgozunk kérdésenként, renderelés után mérve. A Mem0 új algoritmusa a 92.5-öt 7.0K-nál, a 94.4-et 6.8K-nál közli; az AMB ranglistán a Hindsight futás kérdésenként 43.6k kontextus-tokent jelent — a miénk nagyjából kilencszerese. A tokenenkénti pontosság alapján más sorrend alakul ki, mint a nyers pontosság alapján, és a kettő közül általában csak az egyiket közlik. Hadd legyen meg az elismerés: a Mem0 minden pontszám mellett közli az átlagos tokenszámot, ami több, mint amit a ranglisták legtöbb sora ad.
4. A legkínosabb saját felfedezésünk a token-elszámolásunkban volt. Az „5000 tokenes” keretünk valójában 5742 tokent adott át. A dátum-előtagok (- [2026-08-14] ) 15 karakteresek, de 10 tokenesek — a dátumok tokensűrűek —, és egy teljes blokkban ez nagyjából 1.6k tokent jelentett, amit sosem számoltunk el. A valódi keret érvényesítése után a ténylegesen átadott kontextus 4182 tokenre esett, és a pontszámunk a részhalmazon 83.0%-ról 77.7%-ra csökkent. Az újrafuttatás, ahol a keretet úgy emeltük, hogy a ténylegesen átadott kontextus egyezzen a régi 5742-vel, 81.9%-ra állt vissza — vagyis a visszaesés a hiányzó kontextusból jött, nem az elvesztett képességből. A figyelmen kívül hagyott tokeneknek köszönhetően valóban több kérdésre kaptunk helyes választ. Ha nem méred a ténylegesen átadott tokeneket, a kereted dísz.
5. A fő megmaradt hibacsalád az aggregáció. „Hány X összesen”, „Y hány százaléka”. Az egyes előfordulások általában benne vannak a visszakeresett kontextusban — a válaszadó csak nem számolja meg őket megbízhatóan. Ezt az agresszívebb vagy nagyobb mennyiségű visszakeresés sem oldja meg. Ez egyben a gyenge válaszadó-választásunk közvetlen ára is: a flash-lite valóban próbára teszi a visszakeresést, de elbukik olyan számoláson, amit egy erősebb modell nem. Nincs költségmentes módszertani választás.
Ahol a LoCoMo már nem elég
A Mem0 benchmark-posztját épp azért érdemes elolvasni, mert a saját legjobb sora ellen érvel, és a hibamód-listája egyezik a miénkkel: parafrázis-túlillesztés (a rendszerek átmennek, ha a lekérdezés visszhangozza a tárolt megfogalmazást), időbeli revízió (a felhasználó meggondolta magát, és mindkét tény még a tárban van), identitásbeli kétértelműség, eltérő granularitású hatókör-kezelés (felhasználónként vs projektenként vs eszközönként) és lépték — a benchmarkok több száz eseménnyel dolgoznak, az éles rendszerek pedig több millióval.
A saját számaik mutatják a zuhanást: 92.5 a LoCoMo-n és 94.4 a LongMemEval_S-en, de 64.1 a BEAM 1M-en és 48.6 a BEAM 10M-en — ugyanaz a rendszer, ugyanabban az évben, harminc–negyvenöt ponttal alacsonyabb, amint a benchmark interferenciát, frissítéseket és hosszú távú láncokat tartalmaz. Ez sokkal őszintébb kép arról, hol tart valójában a memória, mint bármilyen 9x.x%-os sor, a miénket is beleértve.
A BEAM-et még nem futtattuk. Az a következő, és ugyanúgy publikáljuk — a válaszadóval, a bírálóval, a tényleges tokenszámmal és a kérdésenkénti kimenetekkel csatolva —, bármi is lesz a szám. Az elvárásunk, előre kimondva, hogy cáfolható legyen: a 81.2%-os multi-hop pontszámunk az őszinte előrejelzője annak, hogyan teljesítünk ott, nem a 94.7%-unk.
A mutatók, amelyeket a nyers pontosság helyett javasolnak figyelembe venni — recall@K, végponttól végpontig mért feladatsikeresség, kontextus-felfúvódás, munkamenetek közti folytonosság, parafrázisokkal szembeni stabilitás — a helyes lista. Egyet már publikálunk közülük (a kérdésenként ténylegesen átadott tokenek számát; a 4. pont lent azt mutatja, mi történik, ha nem), a másik négy hiányzik. Szinte mindenkinél hiányzik.
A kód
Publikáltuk a referencia-implementációt: github.com/todoforai/livemem
A mag nagyjából 200 sor TypeScript, mert az architektúra tényleg kicsi:
conversations ──extract──▶ dated facts + embeddings ──pack──▶ ≤ N-token block
                (1 LLM call,                          (cosine + greedy knapsack,
                 offline)                              no LLM on this path)
A konstrukció alapfeltevése: egyszer kinyerünk mindent, kérdésenként választunk, és sosem hívunk LLM-et a visszakereséshez. A kiválasztás koszinusz-hasonlóság plusz egy mohó hátizsák-algoritmus token-keret alatt — néhány tíz milliszekundum —, így megengedheted magadnak, hogy minden egyes kérdésnél újra elvégezd a kiválasztást, ahelyett hogy fenntartanál egy statikus „felhasználói profilt”, ami definíció szerint elavult.
A hosztolt API-nk hozzáteszi a finomhangolt kinyerési promptokat és a fent leírt visszakeresési finomításokat — számtudatos deduplikáció, entitáskártyák, beszélgetésablak-egységek —, és a fenti benchmark-sorokat ebben a konfigurációban futtattuk; a repó ugyanez az architektúra ezen hangolás nélkül. A bench/ alatti benchmark-harness ugyanazon a szolgáltatói interfészen keresztül fut mindkettővel, így magad is megmérheted a különbséget, ahelyett hogy a szavunkat fogadnád el.
A fő soraink mögötti kérdésenkénti kimenetek — válaszok, bírálói ítéletek, kontextus-tokenszámok — a repóban vannak, mindegyik felcímkézve a használt válaszadóval, bírálóval és kerettel. A poszt néhány köztes száma fejlesztés közben futtatott validációs részhalmazokból származik, amelyeket nem publikáltunk teljes artefaktumként; ezek meg vannak jelölve. A más rendszerekről szóló számokat a publikált forrásukra linkeltük, és nem mi futtattuk újra őket. Ha valamiben tévedtünk, az kimutatható — és egy benchmarkkal kapcsolatban csak ilyen, ellenőrizhető állítást érdemes tenni.
Tudjuk, hol vannak a következő pontok: multi-hop 81.2%-nál, aggregáció, a LongMemEval_S, ahol még 6.6 ponttal le vagyunk maradva a Mem0-tól, a BEAM — amit nem futtattunk, és amiről arra számítunk, hogy fájni fog — és a hosztolt éles útvonal, ami még mindig az offline mögött jár. A következő számot ugyanígy publikáljuk — ehhez viszonyítva, a csatolt artefaktumokkal.
Ha úgy szeretnéd használni a memóriát, hogy ne neked kelljen futtatnod, ez működteti a TODOforAI agentmemóriáját.