
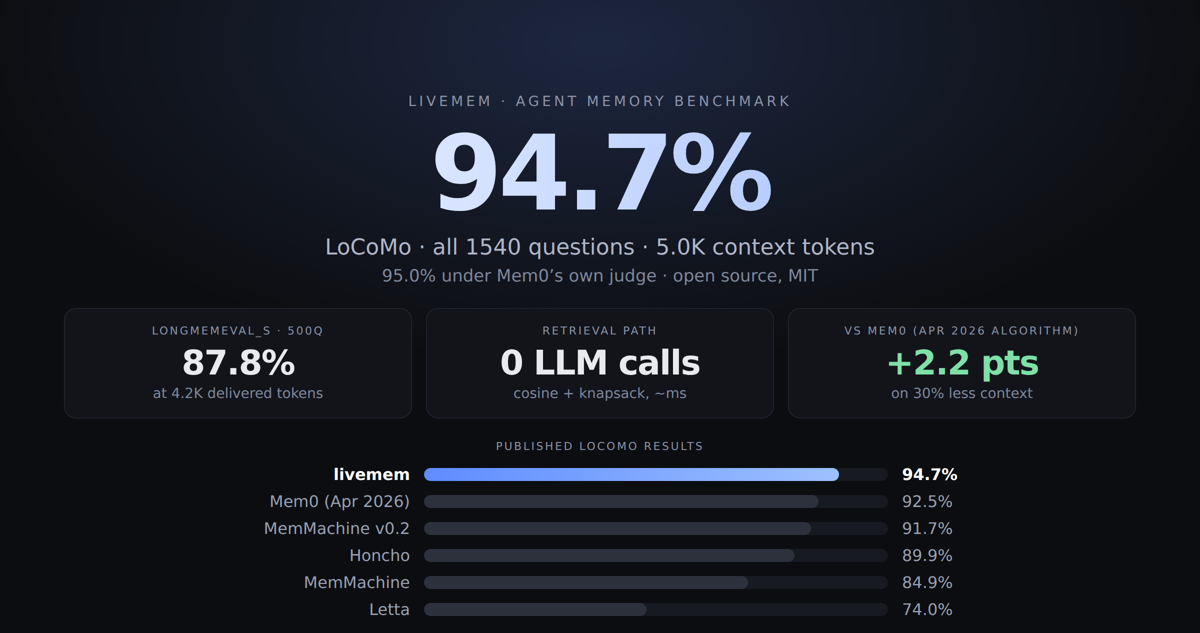
94.7% bei LoCoMo mit 5.0K Kontext-Tokens — 95.0%, wenn Mem0s eigener Judge die Antworten neu bewertet. Die nützlichere Erkenntnis ist das, was wir auf dem Weg dahin gemessen haben.
Die Zahl, samt ihrer Konfiguration
94.7% bei LoCoMo, alle 1540 Fragen, bei 5.0K Kontext-Tokens pro Frage. Das ist die höchste LoCoMo-Zahl, die wir kennen, veröffentlicht oder nicht. Den Code und die Ausgaben pro Frage können wir dir geben (github.com/todoforai/livemem).
Die nächste veröffentlichte Zeile ist Mem0s Algorithmus vom April 2026 mit 92.5 bei durchschnittlich 6956 Kontext-Tokens; danach kommt MemMachine mit 91.7% für v0.2. Also: +2.2 Punkte bei rund 30% weniger Kontext.
Pro Kategorie: Open-Domain 97.0%, Single-Hop 93.6%, Temporal 93.5%, Multi-Hop 81.2%. In der letzten Kategorie steckt die restliche Arbeit. Wir drucken die Zahl lieber ab, als sie wegzumitteln.
Wie viel davon geht auf den Judge zurück? Das wäre unsere erste Frage, also haben wir sie
beantwortet: Wir haben dieselben 1540 Antworten mit gpt-4o-mini und Mem0s eigenem
ACCURACY_PROMPT neu bewertet — dem Judge-Modell und dem Prompt hinter seinen veröffentlichten LoCoMo-Zahlen. Ergebnis:
95.0% (+18 Wechsel zu richtig, −13 in die andere Richtung). Die beiden Judges liegen bei diesen Antworten
innerhalb von 0.3 Punkten. Der Vorsprung ist kein Bewertungsartefakt.
Wie viel davon geht auf das Ensemble zurück? Die Antworten kommen aus zwei Durchläufen über denselben
abgerufenen Memory-Block: gemini-flash und claude-haiku-4-5 beantworten denselben 5.0K-Block
unabhängig voneinander. Dann entscheidet eine Regelhierarchie (agree > commit > abstain) über die 82
Abweichungen. Ein einzelner Durchlauf erreicht 92.4%. Also kommen +2.3 Punkte von der Antwortseite,
erkauft mit einem zweiten Modellaufruf und ~6 Sekunden pro Frage statt einem Aufruf — nicht mit mehr Kontext.
Diese Unterscheidung ist das Thema des ganzen Posts.
Und bevor es jemand anderes sagt: LoCoMo bei 94.7% ist ein fast gesättigter Benchmark. Mem0 sagt das selbst — „ältere Benchmarks wie LoCoMo sind heute weniger aussagekräftig“, weil sie widersprüchliche Updates, Identitätsmehrdeutigkeit oder langlaufende Workflows nicht ausreichend auf die Probe stellen. Wir sehen das genauso, und wir veröffentlichen die Zeile trotzdem. In einem gesättigten Benchmark entscheiden genau die nicht berichteten Variablen über das Ranking: Antwortmodell, Judge, Kontextbudget. Zwei Punkte Luft nach oben und ein Effekt von sieben Punkten durch das Antwortmodell sind kein Leaderboard, sondern ein Messproblem. Der Rest dieses Posts handelt von diesem Messproblem.
Das Setup
Wir bauen TODOforAI, einen Agenten, der langlaufende Aufgaben auf deinem Rechner ausführt. Langlaufend heißt: Er muss sich erinnern. Was du vor drei Wochen entschieden hast, wie dein Deploy-Ablauf aussieht, welche von zwei widersprüchlichen Anweisungen die neuere ist.
Also haben wir ein Memory-System gebaut und dann das getan, was man tun soll: Wir haben es gegen veröffentlichte Zahlen gebenchmarkt, statt unseren eigenen Demos zu trauen.
Zwei öffentliche Datensätze:
- LongMemEval_S — 500 Fragen über lange Chatverläufe mit mehreren Sessions. Recall in einer einzelnen Session, Aggregation über mehrere Sessions, zeitliches Schlussfolgern, Wissens-Updates.
- LoCoMo — 1540 Fragen, mit stärkerem Fokus auf zeitlichem und Multi-Hop-Schlussfolgern.
Beide laufen über AMB, ein unabhängiges Harness, das für jeden Memory-Anbieter den Datensatz, das Antwortmodell und den Judge festlegt.
LoCoMo lief von Anfang an gut. LongMemEval war der ernüchternde Teil, und ist es noch: Unsere erste ehrliche Zahl über den ganzen Datensatz war 85.4%, gegen Mem0s veröffentlichte 94.4%. Heute stehen wir bei 87.8% — besser, aber immer noch dahinter, und zwar bei 4.2K Kontext-Tokens gegen seine 6.8K. Das ist der einzige Teil dieses Vergleichs, mit dem wir zufrieden sind.
Dieses Loch von 9 Punkten hat uns auf Bugsuche geschickt, und die Bugs waren interessanter als die Zahl. Deshalb widmet sich der Rest dieses Posts mehr LongMemEval als dem Benchmark, bei dem wir vorne liegen.
Der Lücke auf der Spur
Die naheliegende Hypothese ist, dass ihre Architektur besser ist. Also haben wir nach unseren eigenen Fehlern gesucht und echte gefunden:
Die Deduplizierung hat Belege gelöscht. Eine Frage wie „Wie viele Pflanzen habe ich letzten Monat gekauft?“ braucht jede Instanz, nicht nur die ähnlichsten Top-k. Unsere Dedup hat „2 Basilikumpflanzen gekauft“ und „3 Basilikumpflanzen gekauft“ zusammengelegt — fast identische Sätze — und damit still eine Instanz zerstört, von der die Zählung abhing. Wir haben die Dedup zahlenbewusst gemacht (zwei Fakten mit unterschiedlichen Ziffern sind nie Duplikate, egal wie ähnlich der Text ist). Das brachte +4.3 Punkte auf einer Validierungsmenge mit 94 Fragen (78.7% → 83.0%).
Die Extraktion war zu wählerisch. Unser Prompt hat Dinge übersprungen, die „ein LLM ohnehin weiß“. Dann fragte jemand „Welches Borges-Zitat hast du mir gegeben?“ — öffentliches Wissen, ja, aber das konkrete Ding, das wir in diesem Gespräch gesagt haben, steckt in keinen Modellgewichten. Die Lehre gilt allgemein: Die Extraktion sollte gierig sein, denn ein Fakt, der nie extrahiert wurde, kann nie abgerufen werden. Wählerisch sein ist Aufgabe des Selektors, nicht des Extraktors. Das hat in unserer Teilmenge drei Fragen gelöst, die vorher unbeantwortbar waren.
Manche Antworten stecken gar nicht in Fakten. Sie stecken in einem Gesprächsbeitrag, der in keiner Zusammenfassung erhalten blieb. Wir haben eine Retrieval-Konfiguration ergänzt, die Entity-Karten und Auszüge aus Gesprächsfenstern mit je 3 Beiträgen zusammen mit den destillierten Fakten mischt. Damit stieg der Lauf über alle 500 Fragen von 85.4% auf 87.8%.
Echte Verbesserungen, echte Punkte. Trotzdem keine 94.4%.
Die Variable, die wir nicht kontrolliert hatten
Das hätten wir am ersten Tag prüfen sollen. Wir hatten mit dem billigsten Modell geantwortet, das wir
finden konnten — gemini-flash-lite — und zwar absichtlich, aus dem oben genannten Grund.
Mem0s veröffentlichte Harness-Konfiguration nutzt gpt-5 als Antwortmodell und gpt-5 als Judge.
Also haben wir den Kontrollversuch durchgeführt: dasselbe Memory-System, dieselben extrahierten Fakten, dasselbe Retrieval, derselbe gerenderte Kontext. Nur das Antwortmodell getauscht.
| Konfiguration (Teilmenge mit 94 Fragen) | Genauigkeit |
|---|---|
| flash-lite als Antwortmodell, flash-lite als Judge | 85.1% |
| gpt-5 als Antwortmodell, flash-lite als Judge | 92.6% (+7.4) |
| gpt-5 als Antwortmodell, gpt-5 als Judge, dieselben Antworten neu bewertet | 90.4% (−2.2) |
+7.4 Punkte allein durch das Antwortmodell. Und auch der Judge ist eine freie Variable — dabei war der stärkere Judge strenger, nicht großzügiger: Er akzeptierte zwei vorsichtig formulierte Antworten, für die wir vorher keine Punkte bekommen hatten, und lehnte vier ab, für die wir vorher Punkte bekommen hatten.
Sei vorsichtig damit, was das zeigt und was nicht. Es beweist nicht, dass Mem0s 94.4% „in Wirklichkeit“ niedriger sind, oder dass die Lücke zwischen zwei Systemen komplett an der Wahl des Antwortmodells liegt — wir haben das System von Mem0 nie mit unserem Harness getestet. Es zeigt etwas Engeres, das trotzdem nützlich ist: Beim selben Memory sind Konfigurationsunterschiede in der Größenordnung der Abstände zwischen veröffentlichten Ergebnissen ungefähr so viele Punkte wert wie die Memory-Architektur selbst. Unsere eigene halbwegs vergleichbare Zahl ist 90.4%, immer noch unter 94.4%. Wir glauben nur nicht mehr, dass der rohe Abstand zwischen zwei unterschiedlich konfigurierten Zeilen irgendetwas misst.
Was wir wirklich gelernt haben
1. Memory-Zahlen aus verschiedenen Harnesses sind kein Ranking. Der klarste Beleg stammt nicht einmal von uns: In der veröffentlichten Literatur taucht Mem0 mit 94.4% (selbst berichtet) und mit 67.6% (gemessen in einer Studie eines Drittanbieters) auf. Dasselbe System, 27 Punkte Unterschied, weil Harness, Antwortmodell, Judge-Prompt und Budget sich unterscheiden. Jede Tabelle, die Quellen mischt — auch die in unserem Repo — ist als Sammlung einzeln konfigurierter Experimente zu lesen, nicht als Leaderboard.
2. Judges sind Punkte wert, nicht Dezimalstellen — und nicht nur über den Prompt. Unsere
Antworten aus einem einzelnen Durchlauf erreichten 92.4% unter claude-haiku-4-5 und 95.6% unter gpt-4o-mini,
bei fast identischen Judge-Prompts. Am Memory hat sich zwischen diesen beiden Zahlen nichts geändert; nur welches Modell
dieselbe Bewertungsanweisung gelesen hat. (Bei den Ensemble-Antworten liegen dieselben beiden Judges innerhalb von 0.3 Punkten
beieinander — die Größe des Judge-Effekts hängt selbst von der Konfiguration ab, und genau das ist der Punkt.)
3. Die Kontextgröße ist eine versteckte Achse. Wir laufen mit ~4–5k Tokens pro Frage, gemessen nach dem Rendern. Mem0s neuer Algorithmus berichtet seine 92.5 bei 7.0K und seine 94.4 bei 6.8K; der Hindsight-Lauf im AMB-Leaderboard berichtet 43.6k Kontext-Tokens pro Frage — etwa 9× so viel wie bei uns. Genauigkeit pro Token ergibt ein anderes Ranking als Genauigkeit, und meistens wird nur eines der beiden berichtet. Ehre, wem Ehre gebührt: Mem0 berichtet neben jedem Score die durchschnittliche Tokenzahl, was mehr ist, als die meisten Leaderboard-Zeilen bieten.
4. Unser peinlichster eigener Fund steckte in unserer Token-Buchhaltung. Unser „5000-Token“-Budget
hat tatsächlich 5742 echte Tokens geliefert. Datumspräfixe (- [2026-08-14] ) sind
15 Zeichen, aber 10 Tokens — Datumsangaben sind token-dicht — und über einen ganzen Block ergab das
etwa 1.6k Tokens, die wir nie mitgezählt hatten. Nachdem wir das echte Budget durchgesetzt hatten, fiel der gelieferte
Kontext auf 4182 Tokens, und der Score auf unserer Teilmenge fiel von 83.0% auf 77.7%. Ein erneuter Lauf mit
so weit erhöhtem Budget, dass der gelieferte Kontext wieder den alten 5742 entsprach, erreichte wieder
81.9% — der Rückgang kam also vom fehlenden Kontext, nicht von verlorener Leistungsfähigkeit. Die ungezählten Tokens
hatten echte Antworten gekauft. Wenn du gelieferte Tokens nicht misst, ist dein Budget Dekoration.
5. Die häufigste verbleibende Fehlerfamilie ist Aggregation. „Wie viele X insgesamt“, „wie viel Prozent von Y“. Die Instanzen stehen meist im abgerufenen Kontext — das Antwortmodell zählt sie nur nicht zuverlässig. Das lässt sich nicht durch härteres Retrieval beheben. Es ist außerdem eine direkte Folge unserer Wahl eines schwachen Antwortmodells: flash-lite stellt das Retrieval auf ehrliche Weise auf die Probe, scheitert aber an Arithmetik, die ein stärkeres Modell lösen würde. Eine Methodik ohne Kompromisse gibt es nicht.
Wo LoCoMo nicht mehr reicht
Mem0s Benchmark-Post ist gerade deshalb lesenswert, weil er gegen die eigene Spitzenzeile argumentiert, und seine Liste von Fehlermodi deckt sich mit unserer: Paraphrase-Overfitting (Systeme bestehen, wenn die Anfrage die gespeicherte Formulierung wiederholt), temporale Revision (der Nutzer hat seine Meinung geändert und beide Fakten liegen noch im Speicher), Identitätsmehrdeutigkeit, Scoping mit gemischter Granularität (pro Nutzer vs. pro Projekt vs. pro Gerät) und Größenordnung — Benchmarks umfassen Hunderte von Events, Produktivsysteme Millionen.
Seine eigenen Zahlen zeigen den Einbruch: 92.5 bei LoCoMo und 94.4 bei LongMemEval_S, aber 64.1 bei BEAM 1M und 48.6 bei BEAM 10M — dasselbe System, dasselbe Jahr, dreißig bis fünfundvierzig Punkte tiefer, sobald der Benchmark Interferenz, Updates und Ketten über lange Zeiträume enthält. Das ist ein viel ehrlicheres Bild davon, wo Memory tatsächlich steht, als jede 9x.x%-Zeile, auch unsere.
Wir haben BEAM noch nicht laufen lassen. Es ist als Nächstes dran, und wir veröffentlichen es auf dieselbe Weise — mit Antwortmodell, Judge, gelieferter Token-Zahl und den Ausgaben pro Frage — egal, wie die Zahl ausfällt. Unsere Erwartung, vorab festgehalten, damit sie widerlegbar ist: Unser Multi-Hop-Score von 81.2% ist der ehrliche Prädiktor dafür, wie wir dort abschneiden, nicht unsere 94.7%.
Die Metriken, die Mem0 statt roher Genauigkeit vorschlägt — Recall@K, End-to-End-Aufgabenerfolg, Context Inflation, Kontinuität über Sessions hinweg, Stabilität bei Paraphrasierung — sind die richtige Liste. Eine davon veröffentlichen wir schon (gelieferte Tokens pro Frage, Punkt 4 unten zeigt, was passiert, wenn man es nicht tut), und die anderen vier fehlen uns. Fast allen anderen auch.
Der Code
Wir haben die Referenzimplementierung veröffentlicht: github.com/todoforai/livemem
Der Kern sind etwa 200 Zeilen TypeScript, denn die Architektur ist wirklich klein:
conversations ──extract──▶ dated facts + embeddings ──pack──▶ ≤ N-token block
                (1 LLM call,                          (cosine + greedy knapsack,
                 offline)                              no LLM on this path)
Die Wette hinter dem Design: Einmal alles extrahieren, pro Frage auswählen, nie ein LLM zum Abrufen aufrufen. Die Auswahl ist Kosinus-Ähnlichkeit plus ein Greedy-Knapsack-Verfahren unter einem Token-Budget — Dutzende Millisekunden —, also kannst du dir leisten, für jede einzelne Frage neu auszuwählen, statt ein statisches „Nutzerprofil“ zu pflegen, das per Definition veraltet ist.
Unsere gehostete API ergänzt optimierte Extraktionsprompts und die oben beschriebenen Retrieval-Verfeinerungen —
zahlenbewusste Dedup, Entity-Karten, Gesprächsfenster-Einheiten —, und die Benchmark-Zeilen oben liefen
in dieser Konfiguration; das Repo ist dieselbe Architektur ohne diese Optimierungen. Das Benchmark-Harness in bench/
kann über denselben Provider wahlweise gegen eines von beiden laufen, sodass du den Unterschied selbst messen kannst, statt uns
beim Wort zu nehmen.
Die Ausgaben pro Frage hinter unseren Hauptzeilen — Antworten, Judge-Urteile, Kontext-Token-Zahlen — liegen in diesem Repo, jeweils mit dem Antwortmodell, dem Judge und dem Budget gekennzeichnet, das verwendet wurde. Einige Zwischenzahlen in diesem Post stammen aus Validierungsmengen, die wir während der Entwicklung haben laufen lassen und nicht als vollständige Artefakte veröffentlicht haben; sie sind entsprechend markiert. Zahlen anderer Systeme sind mit ihrer veröffentlichten Quelle verlinkt und wurden von uns nicht erneut ausgeführt. Wenn wir etwas falsch gemacht haben, ist das widerlegbar, und das ist die einzige Behauptung über einen Benchmark, die etwas wert ist.
Wir wissen, wo die nächsten Punkte liegen: Multi-Hop bei 81.2%, Aggregation, LongMemEval_S, wo wir Mem0 noch um 6.6 Punkte hinterherlaufen, BEAM — das wir noch nicht haben laufen lassen und bei dem wir mit einem schmerzhaften Ergebnis rechnen — und der gehostete Live-Pfad, der noch hinter unserem Offline-Pfad liegt. Wir veröffentlichen die nächste Zahl auf dieselbe Weise — im Vergleich zu dieser gemessen, mit den Artefakten dazu.
Wenn du das Memory willst, ohne es selbst zu betreiben: Es steckt hinter dem Agent-Memory in TODOforAI.