
Mindhárom harnesst mi futtattuk ugyanazon a 89 feladaton, ugyanazzal a modellel és reasoning-beállítással, ugyanazon a gépen, feladatonként egy próbával. TODO for AI: október 26-i futás; Claude Code és Codex: október 5–8-i futások. Nem ranglistás beküldés; lásd lent az összehasonlítást.
Frissítés, október 26.: egy eszköz, egy futás, 81/89
Mind a 89 feladatot újrafuttattuk a TODO for AI 1.0.11-gyel, ugyanazzal az Opus 5.5 high beállítással, ugyanazon a gépen és ugyanazokkal a számolási szabályokkal, mint a lenti október 8-i futásnál. 81/89 (91,0%), egyetlen futásban, újrafuttatás nélkül, $50.82 listaáron. A Claude Code-ot és a Codexet nem futtattuk újra, az október 8-i számaik érvényesek.
| Harness | Sikeres | Költség, listaár | Első hívás kontextusa |
|---|---|---|---|
TODO for AI 1.0.11, bash + tfa-cat (okt. 25–26.) | 81/89 (91,0%) | $50.82 | 1,4k token |
| TODO for AI 1.0.4, bash + read (okt. 6–7., 3 előre jelzett újrafuttatás) | 80/89 (89,9%) | $53.90 | 1,1k token |
| Claude Code 2.1.289 | 78/89 (87,6%) | ≈ $45.68 | ~15,4k token |
| Codex 0.160.1 | 75/89 (84,3%) | ≈ $38.66 | ~15,4k token |
A 81 és a 80 közti különbség zaj. Feladatonként egy próbánál σ ≈ 3 feladat; a 81/89 Wilson 95%-os intervalluma [83,3%, 95,4%], ami még mindig átfed a Claude Code [79,2%, 93,0%] intervallumával. Ez nem bizonyítja, hogy az egyik harness jobb. Azt viszont megmutatja, hogy a külön read eszköz elhagyása nem rontotta az összesített eredményt.
Mi változott. A modell most pontosan egy eszközt kap, a bash-t. A képeket és PDF-eket a tfa-cat <fájl> paranccsal olvassa: ez a bridge-be épített parancs a fájlt a bash-eredményhez csatolja. Az első hívás kontextusa 1,1k-ról 1,4k tokenre nőtt (a tfa-cat bekezdés). Az Opus 4.8-as fallback elutasításnál ugyanúgy be van kapcsolva. A batch-ek között (41–89. feladat) két apró bash-leírás-módosítást kipróbáltunk, majd visszavontunk; a viselkedésen nem változtattak. Tíz feladat hívta a tfa-cat-et; egy feladat sem bukott el azon, hogy egy fájlt nem tudott elolvasni.
Számolás. Ugyanazok a szabályok, mint október 8-án: újrafuttatás csak infrastruktúra- vagy konfigurációs hiba esetén, és ha a fallback sem segít, az elutasítás bukás. Ennél a futásnál egyre sem volt szükség. Hét feladatnál lépett működésbe a 4.8-as fallback, közülük öt sikerült; a többi 82-n a tiszta Opus 5.5 76-ot ért el. A Claude Code saját fallbackjével 78, tiszta 5.5-tel 74.
A nyolc bukás. Három ügynök-időtúllépés (dna-assembly, make-doom-for-mips, extract-moves-from-video), két ellenőrző-időtúllépés 900 s után (model-extraction-relu-logits, torch-tensor-parallelism: a feladat saját tesztje futott ki az időből, nem az ügynök, de a szabály szerint nincs újrafuttatás), két rossz válasz (dna-insert a 4.8-as tartalék után; financial-document-processor, 7-ből 3 teszt: minden összeget jól olvasott ki, egy PDF-et rossz dokumentumhoz sorolt) és a video-processing (5-ből 4 teszt, egyik harness sem oldotta meg soha). Az október 8-án közölt 80/89-hez képest öt feladat lett új siker (crack-7z-hash, az első sikere bármelyik futásunkban, filter-js-from-html, make-mips-interpreter, qemu-alpine-ssh, schemelike-metacircular-eval), négy pedig elveszett (dna-insert, extract-moves-from-video, financial-document-processor, torch-tensor-parallelism). Az a három feladat, amelyhez október 8-án előre jelzett újrafuttatás kellett (break-filter-js-from-html, pypi-server, vulnerable-secret), most elsőre sikerült.
Minden négyzet egy feladat; az elutasítás bukásnak számít. Egy feladatot sem futtattunk újra. Vidd fölé az egeret a feladat azonosítójáért.
All task IDs and outcomes
adaptive-rejection-sampler— passedbn-fit-modify— passedbreak-filter-js-from-html— passedbuild-cython-ext— passedbuild-pmars— passedbuild-pov-ray— passedcaffe-cifar-10— passedcancel-async-tasks— passedchess-best-move— passedcircuit-fibsqrt— passedcobol-modernization— passedcode-from-image— passedcompile-compcert— passedconfigure-git-webserver— passedconstraints-scheduling— passedcount-dataset-tokens— passedcrack-7z-hash— passedcustom-memory-heap-crash— passeddb-wal-recovery— passeddistribution-search— passedextract-elf— passedfeal-differential-cryptanalysis— passedfeal-linear-cryptanalysis— passedfilter-js-from-html— passedfix-code-vulnerability— passedfix-git— passedfix-ocaml-gc— passedgcode-to-text— passedgit-leak-recovery— passedgit-multibranch— passedgpt2-codegolf— passedheadless-terminal— passedhf-model-inference— passedinstall-windows-3.11— passedkv-store-grpc— passedlarge-scale-text-editing— passedlargest-eigenval— passedllm-inference-batching-scheduler— passedlog-summary-date-ranges— passedmailman— passedmake-mips-interpreter— passedmcmc-sampling-stan— passedmerge-diff-arc-agi-task— passedmodernize-scientific-stack— passedmteb-leaderboard— passedmteb-retrieve— passedmulti-source-data-merger— passednginx-request-logging— passedopenssl-selfsigned-cert— passedoverfull-hbox— passedpassword-recovery— passedpath-tracing— passedpath-tracing-reverse— passedpolyglot-c-py— passedpolyglot-rust-c— passedportfolio-optimization— passedprotein-assembly— passedprove-plus-comm— passedpypi-server— passedpytorch-model-cli— passedpytorch-model-recovery— passedqemu-alpine-ssh— passedqemu-startup— passedquery-optimize— passedraman-fitting— passedregex-chess— passedregex-log— passedreshard-c4-data— passedrstan-to-pystan— passedsam-cell-seg— passedsanitize-git-repo— passedschemelike-metacircular-eval— passedsparql-university— passedsqlite-db-truncate— passedsqlite-with-gcov— passedtorch-pipeline-parallelism— passedtrain-fasttext— passedtune-mjcf— passedvulnerable-secret— passedwinning-avg-corewars— passedwrite-compressor— passeddna-assembly— faileddna-insert— failedextract-moves-from-video— failedfinancial-document-processor— failedmake-doom-for-mips— failedmodel-extraction-relu-logits— failedtorch-tensor-parallelism— failedvideo-processing— failed
Eredménylap minden eredménnyel, job-azonosítókkal és a költségbontással: RESULTS_tb21_tfacat_opus-5.5.md.
Frissítés, október 8.: három harness, egy modell (korábbi főszám)
A lenti szeptember 30-i szám kihagyta azt a nyolc feladatot, amelyet a modell elutasított. Ez a frissítés mind a 89 feladatot számolja, az elutasítás bukás, és a ranglistás összevetést saját, ellenőrzött Claude Code- és Codex-futásokkal váltja fel: ugyanaz az Opus 5.5 high beállítással, ugyanazok a feladatok, ugyanaz a Windows/WSL2 gép, ugyanaz a Harbor runner. A három sor között egyedül a harness a változó.
| Harness | Sikeres | Költség, listaár | Első hívás kontextusa |
|---|---|---|---|
| TODO for AI 1.0.4 | 80/89 (89,9%) | $53.90 | 1,1k token |
| Claude Code 2.1.289 | 78/89 (87,6%) | ≈ $45.68 | ~15,4k token |
| Codex 0.160.1 | 75/89 (84,3%) | ≈ $38.66 | ~15,4k token |
Feladatonként egy próba. Wilson 95%-os intervallumok 89 feladaton: 80/89 → [81,9%, 94,6%], 78/89 → [79,2%, 93,0%], 75/89 → [75,3%, 90,4%]; a három átfed. A Vals AI az Opus 5.5-öt 87,6%-on jegyzi a Terminal-Bench 2.1-en, ugyanaz a 78/89, mint a mi Claude Code futásunk.
Miben különböznek a harnessek. A system promptban és az eszközkészletben: nálunk az első modellhívás 1,1k token kontextust visz (egysoros system message, bash és read), a Claude Code-nál és a Codexnél körülbelül 15,4k-t. És az elutasítások kezelésében: az Opus 5.5 néhány bio- és biztonsági feladatot safety-okból elutasít. A Claude Code Opus 4.8-cal próbálja újra, jelzés nélkül; mi ugyanezt tesszük egy explicit refusalFallbackModel beállítással; a Codexnek nincs fallbackje.
Hogyan pontoztuk a Codexet. Tiszta Opus 5.5-tel a Codex 72/89-et ért el, négy kemény elutasítással (break-filter-js-from-html, dna-assembly, protein-assembly, vulnerable-secret). Hogy ugyanazt a fallbacket kapja, mint a másik két harness, ezt a négyet újrafuttattuk a Codexszel Opus 4.8-on; három átment. A Codex 75-tel szerepel, az újrafuttatás $3.08-ja benne van a költségében; enélkül 72/89 (80,9%).
Az újrafuttatási szabály. Egyetlen sweep 77-et adott. Három feladat későbbi futásból számít, mindegyik az újrafuttatás előtt rögzített okkal: pypi-server (infrastruktúra: a CLI-nk az első modellhívás előtt időtúllépett), break-filter-js-from-html (konfiguráció: az 1–20. feladat a 4.8 fallback beállítása előtt futott; újrafuttatva azzal a konfiggal, amit a többi 69 használt), és vulnerable-secret (k=1 elutasítás, k=2 újrafuttatáson 2/2 ugyanazzal a konfiggal). Elutasítást, rossz választ és időtúllépést nem futtattunk újra a pontszámba. Az eredménylap korábbi változatai 79-et írtak: a break-filter-js újrafuttatás a feladattáblában benne volt, a főszámban nem.
Egy négyzet egy feladat; az elutasítások bukásnak számítanak. A csíkozott négyzetek a fenti szabály szerint későbbi futásból kaptak pontot. Az azonosítóhoz vidd fölé az egeret.
All task IDs and outcomes
adaptive-rejection-sampler— passedbn-fit-modify— passedbuild-cython-ext— passedbuild-pmars— passedbuild-pov-ray— passedcaffe-cifar-10— passedcancel-async-tasks— passedchess-best-move— passedcircuit-fibsqrt— passedcobol-modernization— passedcode-from-image— passedcompile-compcert— passedconfigure-git-webserver— passedconstraints-scheduling— passedcount-dataset-tokens— passedcustom-memory-heap-crash— passeddb-wal-recovery— passeddistribution-search— passeddna-insert— passedextract-elf— passedextract-moves-from-video— passedfeal-differential-cryptanalysis— passedfeal-linear-cryptanalysis— passedfinancial-document-processor— passedfix-code-vulnerability— passedfix-git— passedfix-ocaml-gc— passedgcode-to-text— passedgit-leak-recovery— passedgit-multibranch— passedgpt2-codegolf— passedheadless-terminal— passedhf-model-inference— passedinstall-windows-3.11— passedkv-store-grpc— passedlarge-scale-text-editing— passedlargest-eigenval— passedllm-inference-batching-scheduler— passedlog-summary-date-ranges— passedmailman— passedmcmc-sampling-stan— passedmerge-diff-arc-agi-task— passedmodernize-scientific-stack— passedmteb-leaderboard— passedmteb-retrieve— passedmulti-source-data-merger— passednginx-request-logging— passedopenssl-selfsigned-cert— passedoverfull-hbox— passedpassword-recovery— passedpath-tracing— passedpath-tracing-reverse— passedpolyglot-c-py— passedpolyglot-rust-c— passedportfolio-optimization— passedprotein-assembly— passedprove-plus-comm— passedpytorch-model-cli— passedpytorch-model-recovery— passedqemu-startup— passedquery-optimize— passedraman-fitting— passedregex-chess— passedregex-log— passedreshard-c4-data— passedrstan-to-pystan— passedsam-cell-seg— passedsanitize-git-repo— passedsparql-university— passedsqlite-db-truncate— passedsqlite-with-gcov— passedtorch-pipeline-parallelism— passedtorch-tensor-parallelism— passedtrain-fasttext— passedtune-mjcf— passedwinning-avg-corewars— passedwrite-compressor— passedbreak-filter-js-from-html— passed, replacement runpypi-server— passed, replacement runvulnerable-secret— passed, replacement runcrack-7z-hash— faileddna-assembly— failedfilter-js-from-html— failedmake-doom-for-mips— failedmake-mips-interpreter— failedmodel-extraction-relu-logits— failedqemu-alpine-ssh— failedschemelike-metacircular-eval— failedvideo-processing— failed
A kilenc bukás. Egy elutasítás, a crack-7z-hash (az Opus 5.5 és a 4.8 is elutasítja, k=3; a Claude Code megoldja). Négy időtúllépés: filter-js-from-html és make-doom-for-mips (900 s; a doomon mindhárom harness kifut az időből), schemelike-metacircular-eval (2400 s), qemu-alpine-ssh (900 s; a feladat konténerében nincs /dev/kvm, a QEMU szoftveres emulációban fut). Négy rossz válasz: dna-assembly, make-mips-interpreter, model-extraction-relu-logits, video-processing. A video-processing sweep-próbája a mi oldalunkon kapcsolatvesztés volt 306 s-nál; egy tiszta újrafuttatás a rejtett tesztvideón szintén elbukott, így bukásnak számít.
Költség. Token × Anthropic listaár az Opus 5.5-re és 4.8-ra ($5 / $25 millió tokenenként be/ki, $0.50 cache-olvasás, $6.25 cache-írás), feladatonként az utolsó próba, a szolgáltató használati jelentéseiből. A Claude Code és a Codex számai a saját trajektória-tokenjelentéseikből jönnek (ezért ≈): hiányzik belőlük az a két-három feladat, amelyik nem produkált trajektóriát, a Codexnél pedig a cache-írás.
Környezet. Harbor 0.22.0, terminal-bench/terminal-bench-2-1 dataset, Docker WSL2-ben egy Windows-gépen, négy párhuzamos próba, feladatkonténerenként egy CPU. KVM nincs, így a két QEMU-feladat lassabban fut, mint natív Linux hoston, mindhárom harnessnél. Eredménylap minden kimenettel, a számolási szabállyal és a job-azonosítókkal: RESULTS_tb21_full89.md. A pontos agent-konfiguráció nyilvános template-ként elérhető: Terminal-Bench Agent.
A lenti szakaszok a bejegyzés korábbi állapota: a szeptember 30-i Opus 5.5 futás az elutasítások nélkül, majd a GPT-5.6 Sol futások.
Frissítés, szeptember 30.: Opus 5.5 (elavult)
Az október 8-i frissítés leváltotta: ez a számolás kihagyta az elutasított feladatokat.
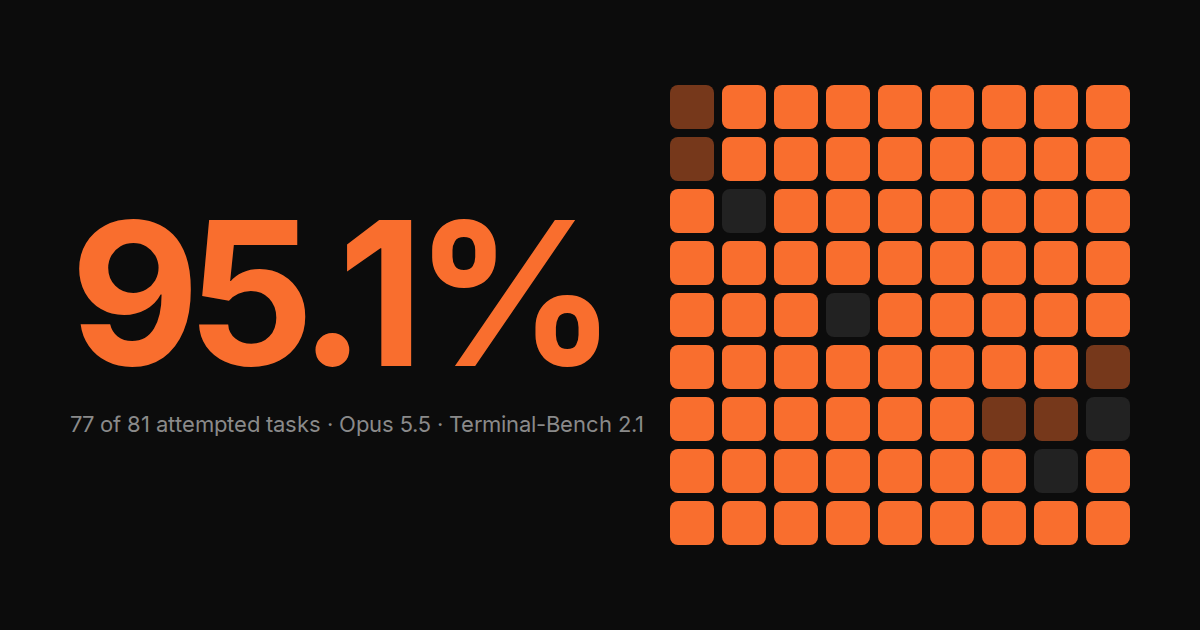
Ugyanazt a 89 feladatot lefuttattuk Claude Opus 5.5-tel, ugyanazzal a harnesszel, mint a Sol review nélküli futásánál: bash, read és web fetch, izolált egygépes bridge, review sub-agent nélkül. A fő szám 95.1% (77/81).
Miért 81 és nem 89. Nyolc feladat el sem indult. Az Anthropic biztonsági osztályozója az elején jelzi őket (három biológiai feladat: dna-assembly, dna-insert, protein-assembly; öt biztonsági feladat: break-filter-js-from-html, filter-js-from-html, crack-7z-hash, password-recovery, vulnerable-secret), a todo egy-két hívás után leáll, és a Harbor ApiError-t rögzít. A modell nem próbálkozott velük, ezért ebben a pontszámban sem sikernek, sem bukásnak nem számítanak, és kimaradnak a nevezőből. Az újrapróbálások többnyire megint elutasításba futnak (az egyik próbán négyet újrapróbáltunk, ebből hármat megint elutasított), ezért nem próbáljuk újra őket. Ha bukásnak számítjuk őket, az eredmény 86.5% (77/89); mindkét szám megtalálható a results sheetben.
| Opus 5.5 | GPT-5.6 Sol, review kikapcsolva | |
|---|---|---|
| Ugyanaz a 81 feladat (elutasítottak nélkül) | 95.1% (77/81) | 82.7% (67/81) |
| Wilson 95%-os intervallum, 81 feladat | [88.0%, 98.1%] | [73.1%, 89.4%] |
| Mind a 89 feladat | 86.5% (77/89) | 82.0% (73/89) |
| Reasoning | xhigh sweep; high 6 újrafuttatásnál | xhigh |
| Dátumok | 2026. szeptember 26–30. | 2026. szeptember 2–4. |
A Sol oszlopa a Sol végleges, review nélküli eredményét használja (73/89, miután egy későbbi újrafuttatás kijavított egy token-lejárati hibát; az alábbi 79.8% a korábbi, 71/89-es pillanatkép). A Sol megpróbálta a nyolc feladatot, és hatot teljesített, így a kizárás az Opusnak kedvez: az Opust 8,5 százalékponttal emeli, a Solt 0,7 százalékponttal. Mind a 89 feladatot számolva is az Opus vezet, 86.5% a 82.0% ellen, de kisebb különbséggel. Az intervallumok átfedik egymást, ezért 81 feladaton a különbség csak jelzésértékű, nem bizonyító erejű.
Költség. $76.75 listaáron a sweepre plusz az időtúllépés- és polyglot-újrafuttatásokra; a két szeptember 30-i qemu/video újrafuttatás még nincs beárazva, ezért vedd alsó határnak. Nem hasonlítható közvetlenül a Sol $61.87-jéhez, mert az feladatonként csak az utolsó próbálkozást számolja.
Újrafuttatások, és egy, amely nekünk kedvez. Kilenc feladatot egy későbbi futás alapján pontozunk, és az utolsó futás számít, akár sikerült, akár nem:
- Harness- vagy verifier-javítások, 4 feladat. A
polyglot-c-pypróbálkozásonként ~300 s-ig állt egy interaktívtzdata-promptnál, amíg a harness be nem állította aDEBIAN_FRONTEND=noninteractive-ot. Aqemu-startupés aqemu-alpine-sshfeladatot az agent megoldotta, de a feladat saját verifierje (debian:bullseye-on) nem tudta telepíteni acurl-t és azsshpass-t, mert a lejárt támogatású security mirror 404-et ad, így minden futás 0-t kapott; a harness most eltávolítja ezt a mirrort a verifier futása előtt. Azextract-moves-from-videoegy CPU-limit javítás után lett újrafuttatva, és még mindig megbukott. - Időtúllépések, 6 feladat,
highreasoninggel újrafuttatva:adaptive-rejection-sampler,cobol-modernization,extract-moves-from-video,make-doom-for-mips,query-optimize,schemelike-metacircular-eval. Ezek agent-időtúllépések voltak, nem infrastruktúrahibák, ezért az újrafuttatás második próbálkozás. Kettő sikeres lett (adaptive-rejection-sampler,cobol-modernization), négy továbbra is megbukott. E kettő nélkül a pontszám 92.6% (75/81).
Egy négyzet egy megkísérelt feladat; a 8 elutasított feladat nincs feltüntetve. A satírozott négyzeteket egy későbbi futás alapján pontoztuk. Ráhúzva megjelenik a feladat azonosítója.
All task IDs and outcomes
bn-fit-modify— passedbuild-cython-ext— passedbuild-pmars— passedbuild-pov-ray— passedcaffe-cifar-10— passedcancel-async-tasks— passedchess-best-move— passedcircuit-fibsqrt— passedcode-from-image— passedcompile-compcert— passedconfigure-git-webserver— passedconstraints-scheduling— passedcount-dataset-tokens— passedcustom-memory-heap-crash— passeddb-wal-recovery— passeddistribution-search— passedextract-elf— passedfeal-differential-cryptanalysis— passedfeal-linear-cryptanalysis— passedfinancial-document-processor— passedfix-code-vulnerability— passedfix-git— passedfix-ocaml-gc— passedgcode-to-text— passedgit-leak-recovery— passedgit-multibranch— passedgpt2-codegolf— passedheadless-terminal— passedhf-model-inference— passedinstall-windows-3.11— passedkv-store-grpc— passedlarge-scale-text-editing— passedlargest-eigenval— passedllm-inference-batching-scheduler— passedlog-summary-date-ranges— passedmailman— passedmake-mips-interpreter— passedmcmc-sampling-stan— passedmerge-diff-arc-agi-task— passedmodel-extraction-relu-logits— passedmodernize-scientific-stack— passedmteb-leaderboard— passedmteb-retrieve— passedmulti-source-data-merger— passednginx-request-logging— passedopenssl-selfsigned-cert— passedoverfull-hbox— passedpath-tracing— passedpath-tracing-reverse— passedpolyglot-rust-c— passedportfolio-optimization— passedprove-plus-comm— passedpypi-server— passedpytorch-model-cli— passedpytorch-model-recovery— passedraman-fitting— passedregex-chess— passedregex-log— passedreshard-c4-data— passedrstan-to-pystan— passedsam-cell-seg— passedsanitize-git-repo— passedsparql-university— passedsqlite-db-truncate— passedsqlite-with-gcov— passedtorch-pipeline-parallelism— passedtorch-tensor-parallelism— passedtrain-fasttext— passedtune-mjcf— passedvideo-processing— passedwinning-avg-corewars— passedwrite-compressor— passedadaptive-rejection-sampler— passed, replacement runcobol-modernization— passed, replacement runpolyglot-c-py— passed, replacement runqemu-alpine-ssh— passed, replacement runqemu-startup— passed, replacement runextract-moves-from-video— failed, replacement runmake-doom-for-mips— failed, replacement runquery-optimize— failed, replacement runschemelike-metacircular-eval— failed, replacement run
A négy bukás: schemelike-metacircular-eval (időtúllépés, hosszú gondolkodási körök), make-doom-for-mips (időtúllépés), extract-moves-from-video (időtúllépés: 951 képkocka OCR-je egy CPU-n) és query-optimize (rossz válasz).
Összehasonlítás. A 78.9% (Claude Code, Opus 4.8) és a 78.4% (Codex, GPT-5.6 Terra) az oldalunkon tbench.ai-ranglistabejegyzések, mind a 89 feladaton, feladatonként több próbával; ugyanazok a nem-egyenértékűségek érvényesek, mint lentebb, és az elutasítások ott bukásnak számítanak. A különbséget tekintsd tájékoztató jellegűnek.
A poszt további része a korábbi GPT-5.6 Sol futásokat dokumentálja.
Korábbi futások: GPT-5.6 Sol
Az Opus 5.5 előtt kétszer futtattuk le a Terminal-Bench 2.1-et ugyanazon a 89 feladaton GPT-5.6 Sollal. A fő szám akkor az egymodelles futás volt: 79.8% (71/89), GPT-5.6 Sol xhigh-on, a review eszköz letiltva. A web fetch az oldalak olvasását továbbra is Claude Haiku 4.5-re bízza ($4.17 a $46.87-ből); a futásban semmi nem vizsgálja és nem ellenőrzi a fő modell munkáját.
A korábbi, augusztus 25–26-i futásban be volt kapcsolva egy review sub-agent Claude Opus 5-ön, és 82.0% (73/89) lett az eredmény. A különbség két feladat, 2,9-szeres költség mellett, és a review által megnyert feladatok épp a „majdnem sikerült” esetek voltak: az egyikben 2 sakklépésből 1, a másikban 4 tesztből 3 volt helyes. A poszt nagy része erről a korábbi futásról szól, mert ehhez van feladatonkénti eredménytábla; a review nélküli futás ugyanazt a harnesst, ugyanazt a pontozási szabályt és ugyanazt a rögzített repót használja, és a results sheetje minden változtatást és minden bukást felsorol.
| Review kikapcsolva (fő szám) | Review bekapcsolva | |
|---|---|---|
| Sikerességi arány | 79.8% (71/89) | 82.0% (73/89) |
| Wilson 95%-os intervallum | [70.3%, 86.8%] | [72.8%, 88.6%] |
| Modellek | GPT-5.6 Sol; Haiku 4.5 web fetchre | + Claude Opus 5 review |
| Költség, promó / listaár | $46.87 / ~$89.6 | $134.51 / $188.33 |
| Dátumok | 2026. szeptember 2–3. | 2026. augusztus 25–26. |
Az alábbi szakaszok a Terminal-Bench 2.1 review-bekapcsolt futását dokumentálják, 2026. augusztus 25–26-án. Ez a poszt azt írja le, hogyan készült ez a szám, hogy helyesen lehessen olvasni: rendszereredmény, megadott újrafuttatási szabállyal, nem hivatalos ranglistás beküldés, és nem egymodelles pontszám.
Minden alábbi adat a nyilvános benchmark repó rögzített results sheetjéből származik. A linkek egy commitra mutatnak, így későbbi szerkesztések nem változtathatják meg csendben, amit a cikk leír.
A tesztelt rendszer
A Terminal-Bench egy izolált konténerben ad feladatot az agentnek — projekt fordítása, adatbázis helyreállítása, szolgáltatás beállítása, kód javítása —, és egy verifier ellenőrzi az eredményül kapott állapotot. Az, hogy az agent sikeresnek nyilvánítja a saját munkáját, lényegtelen; csak a verifier eredménye számít.
- 89 feladatazonosító
- izolált Docker környezet
- elküldi az utasítást
- az edge a konténerben hajtja végre
- a kiszolgált modell az üzenet-metaadatban ellenőrizve
- review → Claude Opus 5
- explore, webfetch → Haiku 4.5
- feladatonként egy végső eredmény
Ennek a konfigurációnak két részlete számít az értelmezésnél.
A 82.0% az egész pipeline-hoz tartozik. A review és az exploration Anthropic modelleken futott ugyanabban a trialben, ezért ez a szám nem írható csak a GPT-5.6 Solnak. A fentebbi review nélküli futás az izoláció: 79.8%.
A kiszolgált modellt ellenőriztük, nem feltételeztük. A CLI fejléce megjeleníti a kért modellt; a futás jegyzetei az egyes assistant-üzenetekhez csatolt szolgáltatói metaadatból igazolják a gpt-5.6-sol-t xhigh-on.
Pontozási szabály és a helyettesítő futások
A results sheet feladatonként egy végső eredményt rögzít. Tizenhat feladatot augusztus 26-án újrafuttattunk, miután az első próbálkozásukat infrastruktúrahiba által érintettnek minősítettük; ezeknél az újrafuttatás eredménye váltja az eredetit.
Egy négyzet egy feladat. A satírozott négyzeteket a helyettesítő futásuk alapján pontoztuk. Ráhúzva megjelenik a feladat azonosítója.
All task IDs and outcomes
bn-fit-modify— passedbuild-pmars— passedcancel-async-tasks— passedchess-best-move— passedcode-from-image— passedconfigure-git-webserver— passedconstraints-scheduling— passedcount-dataset-tokens— passedcrack-7z-hash— passeddb-wal-recovery— passeddistribution-search— passedextract-elf— passedfeal-differential-cryptanalysis— passedfeal-linear-cryptanalysis— passedfinancial-document-processor— passedfix-code-vulnerability— passedfix-git— passedfix-ocaml-gc— passedgcode-to-text— passedgit-leak-recovery— passedgit-multibranch— passedheadless-terminal— passedhf-model-inference— passedinstall-windows-3.11— passedkv-store-grpc— passedlarge-scale-text-editing— passedlargest-eigenval— passedllm-inference-batching-scheduler— passedlog-summary-date-ranges— passedmerge-diff-arc-agi-task— passedmodel-extraction-relu-logits— passedmodernize-scientific-stack— passedmteb-leaderboard— passedmteb-retrieve— passedmulti-source-data-merger— passednginx-request-logging— passedopenssl-selfsigned-cert— passedoverfull-hbox— passedpassword-recovery— passedpath-tracing— passedpath-tracing-reverse— passedpolyglot-c-py— passedpolyglot-rust-c— passedportfolio-optimization— passedprotein-assembly— passedprove-plus-comm— passedpypi-server— passedpytorch-model-cli— passedqemu-alpine-ssh— passedraman-fitting— passedregex-log— passedrstan-to-pystan— passedsanitize-git-repo— passedschemelike-metacircular-eval— passedsparql-university— passedsqlite-db-truncate— passedsqlite-with-gcov— passedtorch-tensor-parallelism— passedtune-mjcf— passedvulnerable-secret— passedwinning-avg-corewars— passedwrite-compressor— passedbreak-filter-js-from-html— passed, replacement runbuild-cython-ext— passed, replacement runbuild-pov-ray— passed, replacement runcaffe-cifar-10— passed, replacement runcobol-modernization— passed, replacement runcompile-compcert— passed, replacement runcustom-memory-heap-crash— passed, replacement rundna-insert— passed, replacement runmailman— passed, replacement runmake-mips-interpreter— passed, replacement runmcmc-sampling-stan— passed, replacement runfilter-js-from-html— failedgpt2-codegolf— failedmake-doom-for-mips— failedpytorch-model-recovery— failedqemu-startup— failedquery-optimize— failedregex-chess— failedreshard-c4-data— failedsam-cell-seg— failedtrain-fasttext— failedvideo-processing— failedadaptive-rejection-sampler— failed, replacement runcircuit-fibsqrt— failed, replacement rundna-assembly— failed, replacement runextract-moves-from-video— failed, replacement runtorch-pipeline-parallelism— failed, replacement run
Ez sem all-attempt pontosság, sem best-of-N. A helyettesítés ott érvényesül, ahol van újrafuttatás, függetlenül attól, melyik eredmény volt jobb, és a 16 helyettesítésből 11 sikeres lett, 5 megbukott. A szabály mégis a rendszernek kedvez: csak azokat a feladatokat futtattuk újra, amelyek első próbálkozását infrastruktúrahiba által érintettnek minősítettük, és a sheet nem rögzíti ezek eredeti eredményét. A sheet összesen 102 trialt számol 16 újrafuttatottként megjelölt feladat mellett, ezt az eltérést nem oldja fel. Bármely olyan protokollal való összehasonlításnál, amely minden trialt átlagol, mindkét pontot figyelembe kell venni.
A 16 helyettesítő futás alapján pontozott feladat: adaptive-rejection-sampler, break-filter-js-from-html, build-cython-ext, build-pov-ray, caffe-cifar-10, circuit-fibsqrt, cobol-modernization, compile-compcert, custom-memory-heap-crash, dna-assembly, dna-insert, extract-moves-from-video, mailman, make-mips-interpreter, mcmc-sampling-stan, torch-pipeline-parallelism. Ezek közül öt a tizenhat végső bukás között van.
Statisztikai pontosság
Nem futott ismételt teljes sweep, ezért a sheet nem ad intervallumot. Egyetlen binomiális arányra a Wilson 95%-os intervallum érzékelteti, mennyit mozdulhat egy eredmény ennyi feladatnál:
ahol , , .
Az intervallum szemléltető jellegű. Független trialeket és feladatonként fix sikerességi valószínűséget feltételez, és nem modellezi a helyettesítési szabályt vagy a feladatok eltérő nehézségét. Azt viszont megmutatja, mekkora a skála: két egyszeres sweep eredménye között néhány pont különbség 89 feladaton bőven ezen a tartományon belül van, és önmagában nem bizonyíték arra, hogy az egyik rendszer jobb.
Mivel hasonlítható az eredmény
Az oldalunk ma már az október 26-i eredményünket mutatja az október 8-i Claude Code- és Codex-futások mellett, mindet mi mértük ugyanazon a modellen és feladatokon (lásd a bejegyzés elején). E szakasz írásakor a tbench.ai ranglista bejegyzéseit mutatta, a Claude Code-ot 78.9%-on, a Codexet 78.4%-on, a Sol-eredményünk mellett. A lenti táblázat a Sol-futásokat írja le a ranglista szabályaival szemben; ugyanezek a nem-egyenértékűségek az Opus 5.5 futásokra is érvényesek.
| Dimenzió | tbench.ai ranglista | Ez a futás |
|---|---|---|
| Pontosság | sikerek ÷ összes trial; az újrafuttatások beleátlagolva | feladatonként egy végső eredmény; az újrafuttatások helyettesítenek |
| Trial feladatonként | ≥ 5 a listázott bejegyzéseknél | 1, 16 feladat helyettesítő futás alapján pontozva |
| Költség | minden trial összege | csak feladatonként az utolsó próbálkozás |
| Tokenszám | input + output; a cache tokenek nélkül | mind a négy osztály, a cache readekkel együtt |
| Modell | beküldött formában, modellenként egy bejegyzés | 79.8%: GPT-5.6 Sol, Haiku web fetchre · 82.0%: + Opus review |
A ranglista saját szabálya szerint — minden próbálkozás átlagolva, nem helyettesítve — mindkét futás rendre 79,8% és 82,0% alatti eredményt kapna, ha a lecserélt próbálkozások bukásnak számítanak, és a költsége a trialek számával skálázódna. A repóban lévő összehasonlíthatósági jegyzetek végigvezetnek a korrekciókon.
Egy terminálos benchmark is csak szűk szeletét méri annak, amit egy agenttermék csinál. Semmit nem mond az e-mailről, CRM-munkáról, böngészős feladatokról, jogosultságokról vagy csapatmunkafolyamatokról. Ezekhez lásd: TODO for AI vs Claude Code, vs Codex vagy az összehasonlító jegyzék.
A review-bekapcsolt futás költsége: három modell, négy tokenosztály
A költséget a szolgáltatói használati jelentésekből számoljuk, minden feladat utolsó próbálkozására, beleértve az egyes trialekből linkelt sub-agent todókat. Az elhagyott, infrastruktúrahiba által érintett próbálkozásokat nem áraztuk be.
| Modell | Szerep | Input | Output | Cache read | Cache write |
|---|---|---|---|---|---|
| GPT-5.6 Sol | fő ciklus | 7.65M | 0.95M | 144.94M | 0 |
| Claude Opus 5 | review | ~0 | 1.74M | 24.31M | 2.68M |
| Claude Haiku 4.5 | explore, webfetch | 0.24M | 0.50M | 18.98M | 2.96M |
| Modell | $/Mtok — in / out / cache read / cache write | Költség | Feladatonként |
|---|---|---|---|
| GPT-5.6 Sol | 2 / 10 / 0.2 / 2.5 (promó) | $53.82 | $0.60 |
| Claude Opus 5 | 5 / 25 / 0.5 / 6.25 | $72.37 | $0.81 |
| Claude Haiku 4.5 | 1 / 5 / 0.1 / 1.25 | $8.32 | $0.09 |
| Összesen | $134.51 | $1.51 |
A táblázatból három megfigyelés következik közvetlenül.
- A review sub-agent többe kerül, mint a benchmarkolt modell — $72.37 a $53.82 ellenében, nagyjából 50 review hívásból, szinte teljes egészében az Opus kimeneti tokenjeiből és cache-írásaiból. A review kikapcsolása (a 79.8%-os futás) az összeget $46.87-re vitte le.
- A cache read az elküldött tokenek 93%-a. Egy agent-ciklus minden körben újraküldi a kontextusát. Az a tokenszám, amely csak
input + output-ot jelent — mint a ranglista token oszlopa —, a szolgáltatók által számlázott forgalom kis töredékét írja le. - Az ár paraméter, a tokenmennyiség pedig a mért érték. A GPT-5.6 Sol teljes listaárán (4 / 20 / 0.4 / 5) az összeg $188.33, azaz $2.12 feladatonként $1.51 helyett. A saját számlázási főkönyvünk szándékosan nem a fő szám: promóciós kedvezményeket tartalmaz, amelyeket kívülről senki nem tud reprodukálni.
A tizenhat bukás
adaptive-rejection-sampler, circuit-fibsqrt, dna-assembly, extract-moves-from-video, filter-js-from-html, gpt2-codegolf, make-doom-for-mips, pytorch-model-recovery, qemu-startup, query-optimize, regex-chess, reshard-c4-data, sam-cell-seg, torch-pipeline-parallelism, train-fasttext, video-processing.
Tizenegy az eredeti sweepen bukott meg, öt egy helyettesítő futáson. A sheet az eredményeket rögzíti, nem a kiváltó okokat, és ez a poszt egyiket sem minősíti át infrastruktúra-problémának.
A konfiguráció reprodukálása
Nyilvános bemenetek:
- Results sheet, október 8. — mind a 89 eredmény a három harnessre, számolási szabály, job-azonosítók
- Results sheet, Sol-futások — token- és árazási táblák
- Feladatlista
- Harbor adapter
- Token-elszámoló script
Az adapter egy hosztolt backendet hív, és egy app nevű, fiókban beállított agentet használ. A modellhozzáférés, a reasoning beállítás, a sub-agent modellek és az eszközjogosultságok a fiókban vannak, nem a repóban, ezért egy klón kiindulópont, nem hermetikus visszajátszás. Használj dedikált benchmark fiókot és Docker hosztot, amelyen nincsenek a benchmarkhoz nem kapcsolódó hitelesítő adatok. Egyetlen feladat futtatása:
git clone https://github.com/todoforai/benchmarks.git
cd benchmarks && git checkout 0133572
cd terminal-bench
python3 -m venv .venv && . .venv/bin/activate && pip install -e .

: "${TODOFORAI_API_KEY:?Set a dedicated benchmark API key first}"
export TODOFORAI_API_KEY

harbor run \
  -d "terminal-bench/terminal-bench-2-1" \
  --agent-import-path "todoforai_tbench:TODOforAIHarborAgent" \
  -m "anthropic:anthropic/claude-opus-5.5" \
  -i "terminal-bench/openssl-selfsigned-cert" \
  --job-name "tb21-single-task" \
  --max-retries 0 \
  --yes -n 1
A -m kapcsoló a fő modellt választja; a reasoning szint, a refusal fallback és az eszközjogosultságok az agentből jönnek. A terminal-bench-89 template ezt az agentet hozza létre az október 8-i konfigurációval; az október 26-i futáshoz csak device:BASH és device:tfa-cat engedélyezett (read eszköz nincs), TODO for AI 1.0.11 / bridge 1.5.71 (lásd az október 26-i eredménylapot). A kiszolgált modellt ellenőrizd a visszakapott üzenet-metaadatokból, mielőtt megbíznál egy sweep eredményében.
Ha a futást a ranglistával akarod összehasonlítani: rögzítsd a függőségek verzióit és az agent beállításait az indulás előtt, tarts meg minden próbálkozást, előre deklaráld az újrapróbálási szabályt, és az összes próbálkozásra számított pontosságot a helyettesítő futásokon alapuló diagnosztikai eredményektől elkülönítve közöld.