
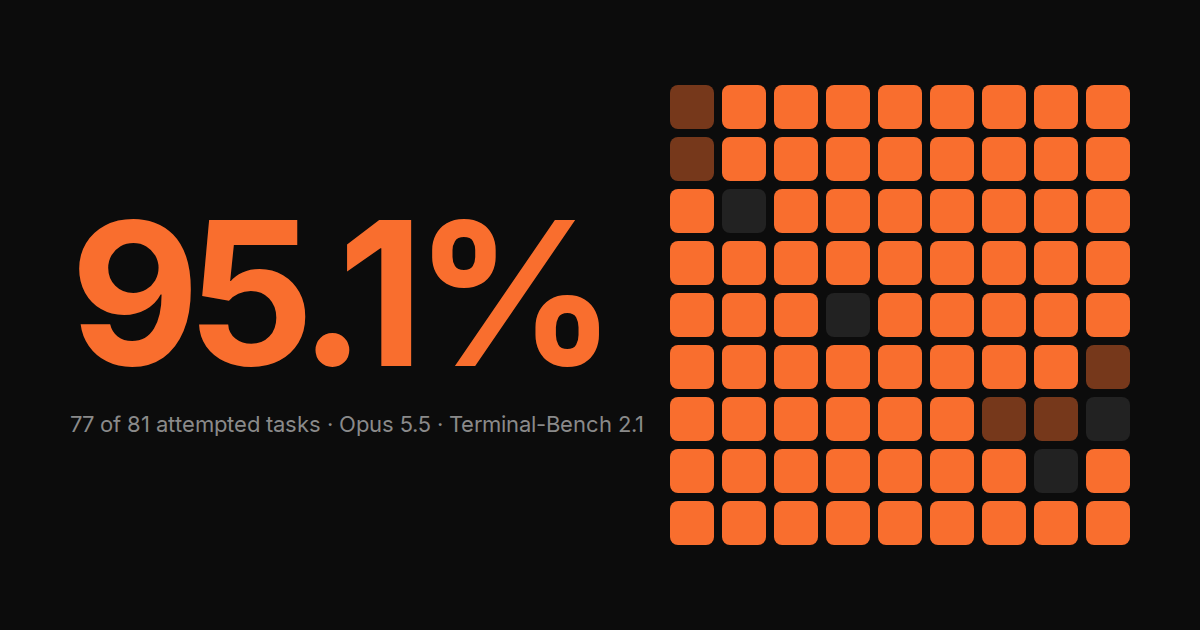
Alle drei Harnesses von uns auf denselben 89 Tasks gefahren, dasselbe Modell mit derselben Reasoning-Einstellung, dieselbe Maschine, ein Versuch pro Task. TODO for AI: Lauf vom 26. Oktober; Claude Code und Codex: Läufe vom 5.–8. Oktober. Keine Leaderboard-Einreichung; siehe den Vergleich unten.
Update vom 26. Oktober: ein Tool, ein Durchlauf, 81/89
Wir haben alle 89 Tasks mit TODO for AI 1.0.11 erneut gefahren, mit demselben Opus 5.5 auf high, derselben Maschine und denselben Zählregeln wie beim Lauf vom 8. Oktober unten. 81/89 (91.0%), in einem einzigen Durchlauf ohne Reruns, für $50.82 zum Listenpreis. Claude Code und Codex wurden nicht erneut gefahren; ihre Zahlen vom 8. Oktober gelten weiter.
| Harness | Bestanden | Kosten, Listenpreis | Kontext des ersten Aufrufs |
|---|---|---|---|
TODO for AI 1.0.11, bash + tfa-cat (25.–26. Okt.) | 81/89 (91.0%) | $50.82 | 1,4k Tokens |
| TODO for AI 1.0.4, bash + read (6.–7. Okt., 3 angekündigte Reruns) | 80/89 (89.9%) | $53.90 | 1,1k Tokens |
| Claude Code 2.1.289 | 78/89 (87.6%) | ≈ $45.68 | ~15,4k Tokens |
| Codex 0.160.1 | 75/89 (84.3%) | ≈ $38.66 | ~15,4k Tokens |
81 gegen 80 ist Rauschen. Ein Versuch pro Task ergibt σ ≈ 3 Tasks; das Wilson-95%-Intervall für 81/89 ist [83.3%, 95.4%] und überlappt weiterhin mit dem von Claude Code, [79.2%, 93.0%]. Das beweist nicht, dass ein Harness besser ist. Es zeigt aber: Ohne das separate read-Tool sank die Gesamtzahl nicht.
Was sich geändert hat. Das Modell bekommt jetzt genau ein Tool, bash. Bilder und PDFs liest es mit tfa-cat <datei>, einem in unsere Bridge eingebauten Befehl, der die Datei an das Bash-Ergebnis anhängt. Der Kontext des ersten Aufrufs wuchs von 1,1k auf 1,4k Tokens (der tfa-cat-Absatz). Der Opus-4.8-Fallback bei Ablehnungen ist wie zuvor aktiv. Zwischen den Batches (Tasks 41–89) wurden zwei kleine Änderungen an der Bash-Beschreibung getestet und wieder zurückgenommen; sie änderten das Verhalten nicht. Zehn Tasks haben tfa-cat aufgerufen; kein Task ist daran gescheitert, dass eine Datei nicht lesbar war.
Zählung. Dieselben Regeln wie am 8. Oktober: Reruns nur bei Infrastruktur- oder Konfigurationsfehlern, Ablehnungen, die der Fallback nicht auffängt, zählen als Fehlschlag. Dieser Durchlauf brauchte keinen Rerun. Sieben Tasks liefen über den 4.8-Fallback (fünf bestanden); reines Opus 5.5 kam auf den übrigen 82 auf 76. Claude Code kommt mit seinem eigenen Fallback auf 78, mit reinem 5.5 auf 74.
Die acht Fehlschläge. Drei Agent-Timeouts (dna-assembly, make-doom-for-mips, extract-moves-from-video), zwei Verifier-Timeouts nach 900 s (model-extraction-relu-logits, torch-tensor-parallelism: der Test des Tasks lief in das Zeitlimit, nicht der Agent, nach den Regeln gibt es trotzdem keinen Rerun), zwei falsche Antworten (dna-insert nach dem 4.8-Fallback; financial-document-processor, 3 von 7 Tests: jeder Betrag richtig gelesen, ein PDF dem falschen Dokument zugeordnet) und video-processing (4 von 5 Tests, von keinem Harness je bestanden). Gegenüber den veröffentlichten 80/89 vom 8. Oktober kamen fünf Tasks hinzu (crack-7z-hash, erstmals in einem unserer Läufe, filter-js-from-html, make-mips-interpreter, qemu-alpine-ssh, schemelike-metacircular-eval), vier gingen verloren (dna-insert, extract-moves-from-video, financial-document-processor, torch-tensor-parallelism). Die drei Tasks, die am 8. Oktober einen angekündigten Rerun brauchten (break-filter-js-from-html, pypi-server, vulnerable-secret), bestanden diesmal im ersten Versuch.
Jedes Feld ist ein Task; Ablehnungen zählen als Fehlschlag. Kein Task wurde erneut gefahren. Für die Task-ID mit der Maus darüberfahren.
All task IDs and outcomes
adaptive-rejection-sampler— passedbn-fit-modify— passedbreak-filter-js-from-html— passedbuild-cython-ext— passedbuild-pmars— passedbuild-pov-ray— passedcaffe-cifar-10— passedcancel-async-tasks— passedchess-best-move— passedcircuit-fibsqrt— passedcobol-modernization— passedcode-from-image— passedcompile-compcert— passedconfigure-git-webserver— passedconstraints-scheduling— passedcount-dataset-tokens— passedcrack-7z-hash— passedcustom-memory-heap-crash— passeddb-wal-recovery— passeddistribution-search— passedextract-elf— passedfeal-differential-cryptanalysis— passedfeal-linear-cryptanalysis— passedfilter-js-from-html— passedfix-code-vulnerability— passedfix-git— passedfix-ocaml-gc— passedgcode-to-text— passedgit-leak-recovery— passedgit-multibranch— passedgpt2-codegolf— passedheadless-terminal— passedhf-model-inference— passedinstall-windows-3.11— passedkv-store-grpc— passedlarge-scale-text-editing— passedlargest-eigenval— passedllm-inference-batching-scheduler— passedlog-summary-date-ranges— passedmailman— passedmake-mips-interpreter— passedmcmc-sampling-stan— passedmerge-diff-arc-agi-task— passedmodernize-scientific-stack— passedmteb-leaderboard— passedmteb-retrieve— passedmulti-source-data-merger— passednginx-request-logging— passedopenssl-selfsigned-cert— passedoverfull-hbox— passedpassword-recovery— passedpath-tracing— passedpath-tracing-reverse— passedpolyglot-c-py— passedpolyglot-rust-c— passedportfolio-optimization— passedprotein-assembly— passedprove-plus-comm— passedpypi-server— passedpytorch-model-cli— passedpytorch-model-recovery— passedqemu-alpine-ssh— passedqemu-startup— passedquery-optimize— passedraman-fitting— passedregex-chess— passedregex-log— passedreshard-c4-data— passedrstan-to-pystan— passedsam-cell-seg— passedsanitize-git-repo— passedschemelike-metacircular-eval— passedsparql-university— passedsqlite-db-truncate— passedsqlite-with-gcov— passedtorch-pipeline-parallelism— passedtrain-fasttext— passedtune-mjcf— passedvulnerable-secret— passedwinning-avg-corewars— passedwrite-compressor— passeddna-assembly— faileddna-insert— failedextract-moves-from-video— failedfinancial-document-processor— failedmake-doom-for-mips— failedmodel-extraction-relu-logits— failedtorch-tensor-parallelism— failedvideo-processing— failed
Ergebnisblatt mit allen Ergebnissen, Job-IDs und der Kostenaufteilung: RESULTS_tb21_tfacat_opus-5.5.md.
Update vom 8. Oktober: drei Harnesses, ein Modell (vorherige Hauptzahl)
Die Zahl vom 30. September weiter unten ließ die acht Tasks weg, die das Modell abgelehnt hat. Dieses Update zählt alle 89 Tasks, Ablehnungen als Fehlschläge, und ersetzt den Leaderboard-Vergleich durch eigene, kontrollierte Läufe von Claude Code und Codex: dasselbe Opus 5.5 mit high, dieselben Tasks, dieselbe Windows/WSL2-Maschine, derselbe Harbor-Runner. Der Harness ist die einzige Variable zwischen den drei Zeilen.
| Harness | Bestanden | Kosten, Listenpreis | Kontext des ersten Aufrufs |
|---|---|---|---|
| TODO for AI 1.0.4 | 80/89 (89.9%) | $53.90 | 1,1k Tokens |
| Claude Code 2.1.289 | 78/89 (87.6%) | ≈ $45.68 | ~15,4k Tokens |
| Codex 0.160.1 | 75/89 (84.3%) | ≈ $38.66 | ~15,4k Tokens |
Ein Versuch pro Task. Wilson-95%-Intervalle über 89 Tasks: 80/89 → [81.9%, 94.6%], 78/89 → [79.2%, 93.0%], 75/89 → [75.3%, 90.4%]; die drei überlappen. Vals AI führt Opus 5.5 auf Terminal-Bench 2.1 mit 87.6%, dieselben 78/89 wie unser Claude-Code-Lauf.
Was sich zwischen den Harnesses unterscheidet. System-Prompt und Werkzeugsatz: unser erster Modellaufruf trägt 1,1k Tokens Kontext (eine einzeilige System-Message, bash und read), Claude Code und Codex etwa 15,4k. Und der Umgang mit Ablehnungen: Opus 5.5 lehnt einige Bio- und Security-Tasks aus Safety-Gründen ab. Claude Code versucht es mit Opus 4.8 erneut, ohne das zu melden; wir tun dasselbe über eine explizite refusalFallbackModel-Einstellung; Codex hat keinen Fallback.
Wie Codex gewertet wurde. Auf reinem Opus 5.5 kam Codex auf 72/89, mit vier harten Ablehnungen (break-filter-js-from-html, dna-assembly, protein-assembly, vulnerable-secret). Damit Codex denselben Fallback bekommt wie die beiden anderen Harnesses, haben wir diese vier mit Codex auf Opus 4.8 erneut gefahren; drei bestanden. Codex steht bei 75, die $3.08 dieses Reruns sind in seinen Kosten enthalten; ohne ihn 72/89 (80.9%).
Die Rerun-Regel. Ein einzelner Sweep ergab 77. Drei Tasks werden aus einem späteren Lauf gewertet, jeder mit einem vor dem Rerun festgelegten Grund: pypi-server (Infrastruktur: unsere CLI lief vor dem ersten Modellaufruf in einen Timeout), break-filter-js-from-html (Konfiguration: die Tasks 1–20 liefen, bevor der 4.8-Fallback gesetzt war; Rerun mit der Konfiguration der übrigen 69 Tasks) und vulnerable-secret (eine k=1-Ablehnung, 2/2 in einem k=2-Rerun mit derselben Konfiguration). Ablehnungen, falsche Antworten und Timeouts wurden nicht in die Wertung nachgefahren. Frühere Versionen des Ergebnisblatts nannten 79: der break-filter-js-Rerun stand in der Task-Tabelle, nicht in der Kopfzahl.
Jedes Feld ist ein Task; Ablehnungen zählen als Fehlschlag. Schraffierte Felder wurden nach der obigen Regel aus einem späteren Lauf gewertet. Hover zeigt die Task-ID.
All task IDs and outcomes
adaptive-rejection-sampler— passedbn-fit-modify— passedbuild-cython-ext— passedbuild-pmars— passedbuild-pov-ray— passedcaffe-cifar-10— passedcancel-async-tasks— passedchess-best-move— passedcircuit-fibsqrt— passedcobol-modernization— passedcode-from-image— passedcompile-compcert— passedconfigure-git-webserver— passedconstraints-scheduling— passedcount-dataset-tokens— passedcustom-memory-heap-crash— passeddb-wal-recovery— passeddistribution-search— passeddna-insert— passedextract-elf— passedextract-moves-from-video— passedfeal-differential-cryptanalysis— passedfeal-linear-cryptanalysis— passedfinancial-document-processor— passedfix-code-vulnerability— passedfix-git— passedfix-ocaml-gc— passedgcode-to-text— passedgit-leak-recovery— passedgit-multibranch— passedgpt2-codegolf— passedheadless-terminal— passedhf-model-inference— passedinstall-windows-3.11— passedkv-store-grpc— passedlarge-scale-text-editing— passedlargest-eigenval— passedllm-inference-batching-scheduler— passedlog-summary-date-ranges— passedmailman— passedmcmc-sampling-stan— passedmerge-diff-arc-agi-task— passedmodernize-scientific-stack— passedmteb-leaderboard— passedmteb-retrieve— passedmulti-source-data-merger— passednginx-request-logging— passedopenssl-selfsigned-cert— passedoverfull-hbox— passedpassword-recovery— passedpath-tracing— passedpath-tracing-reverse— passedpolyglot-c-py— passedpolyglot-rust-c— passedportfolio-optimization— passedprotein-assembly— passedprove-plus-comm— passedpytorch-model-cli— passedpytorch-model-recovery— passedqemu-startup— passedquery-optimize— passedraman-fitting— passedregex-chess— passedregex-log— passedreshard-c4-data— passedrstan-to-pystan— passedsam-cell-seg— passedsanitize-git-repo— passedsparql-university— passedsqlite-db-truncate— passedsqlite-with-gcov— passedtorch-pipeline-parallelism— passedtorch-tensor-parallelism— passedtrain-fasttext— passedtune-mjcf— passedwinning-avg-corewars— passedwrite-compressor— passedbreak-filter-js-from-html— passed, replacement runpypi-server— passed, replacement runvulnerable-secret— passed, replacement runcrack-7z-hash— faileddna-assembly— failedfilter-js-from-html— failedmake-doom-for-mips— failedmake-mips-interpreter— failedmodel-extraction-relu-logits— failedqemu-alpine-ssh— failedschemelike-metacircular-eval— failedvideo-processing— failed
Die neun Fehlschläge. Eine Ablehnung, crack-7z-hash (Opus 5.5 und 4.8 lehnen beide ab, k=3; Claude Code besteht ihn). Vier Timeouts: filter-js-from-html und make-doom-for-mips (900 s; bei Doom laufen alle drei Harnesses in den Timeout), schemelike-metacircular-eval (2400 s), qemu-alpine-ssh (900 s; der Task-Container hat kein /dev/kvm, QEMU läuft also in Software-Emulation). Vier falsche Antworten: dna-assembly, make-mips-interpreter, model-extraction-relu-logits, video-processing. Der Sweep-Versuch von video-processing war ein Verbindungsabbruch auf unserer Seite bei 306 s; ein sauberer Rerun scheiterte ebenfalls am versteckten Testvideo, er zählt also als Fehlschlag.
Kosten. Tokens × Anthropic-Listenpreis für Opus 5.5 und 4.8 ($5 / $25 pro Million ein/aus, $0.50 Cache-Lesen, $6.25 Cache-Schreiben), letzter Versuch pro Task, aus den Nutzungsberichten des Anbieters. Die Zahlen für Claude Code und Codex stammen aus deren eigenen Trajektorien-Token-Berichten (daher ≈): ihnen fehlen die zwei bis drei Tasks ohne Trajektorie und bei Codex die Cache-Schreibvorgänge.
Umgebung. Harbor 0.22.0, Dataset terminal-bench/terminal-bench-2-1, Docker in WSL2 auf einer Windows-Maschine, vier Versuche parallel, eine CPU pro Task-Container. Kein KVM, die beiden QEMU-Tasks laufen also langsamer als auf einem nativen Linux-Host, bei allen drei Harnesses. Ergebnisblatt mit jedem Ausgang, der Zählregel und den Job-IDs: RESULTS_tb21_full89.md. Die exakte Agent-Konfiguration ist als Template öffentlich: Terminal-Bench Agent.
Die Abschnitte darunter sind der frühere Stand dieses Beitrags: der Opus-5.5-Lauf vom 30. September ohne Ablehnungen, dann die GPT-5.6-Sol-Läufe.
Update vom 30. September: Opus 5.5 (überholt)
Überholt durch das Update vom 8. Oktober: diese Zählung ließ die abgelehnten Tasks weg.
Wir haben dieselben 89 Tasks mit Claude Opus 5.5 auf demselben Harness laufen lassen wie den Sol-Lauf ohne Review: bash, read und web fetch, eine isolierte Single-Machine-Bridge, kein Review-Sub-Agent. Das Hauptergebnis ist 95.1% (77/81).
Warum 81, nicht 89. Acht Tasks sind nie gelaufen. Anthropics Safety-Classifier markiert sie gleich zu Beginn (drei Biologie-Tasks: dna-assembly, dna-insert, protein-assembly; fünf Security-Tasks: break-filter-js-from-html, filter-js-from-html, crack-7z-hash, password-recovery, vulnerable-secret), das Todo stoppt nach ein oder zwei Aufrufen, und Harbor protokolliert einen ApiError. Das Modell hat sie nicht versucht. In diesem Score zählen sie deshalb weder als bestanden noch als durchgefallen und bleiben aus dem Nenner draußen. Wiederholungen werden meist wieder abgelehnt (bei einem Retry von vier dieser Tasks wurden drei abgelehnt), deshalb wiederholen wir sie nicht. Zählt man sie als Fehlschläge, ergibt das 86.5% (77/89). Beide Zahlen stehen im Ergebnisblatt.
| Opus 5.5 | GPT-5.6 Sol, Review aus | |
|---|---|---|
| Dieselben 81 Tasks (Abgelehnte ausgenommen) | 95.1% (77/81) | 82.7% (67/81) |
| Wilson-95%-Intervall, 81 Tasks | [88.0%, 98.1%] | [73.1%, 89.4%] |
| Alle 89 Tasks | 86.5% (77/89) | 82.0% (73/89) |
| Reasoning | xhigh-Sweep; high bei 6 Reruns | xhigh |
| Zeitraum | 26–30 September 2026 | 2–4 September 2026 |
Die Sol-Spalte nutzt Sols finales Ergebnis ohne Review (73/89, nachdem ein späterer Rerun einen Token-Ablauf-Bug behoben hat; die 79.8% weiter unten sind der frühere Stand mit 71/89). Sol versucht die acht Tasks und hat sechs davon bestanden. Der Ausschluss begünstigt also Opus: Er hebt Opus um 8.5 Punkte und Sol um 0.7. Zählt man alle 89 Tasks, liegt Opus weiterhin vorn, 86.5% zu 82.0%, aber mit kleinerem Abstand. Die Intervalle überlappen sich. Auf 81 Tasks ist der Abstand also ein Hinweis, kein Beweis.
Kosten. $76.75 zum Listenpreis für den Sweep plus die Reruns für Timeouts und polyglot. Die zwei qemu-/video-Reruns vom 30 September sind noch nicht bepreist, die Zahl ist also eine Untergrenze. Sie ist nicht direkt mit Sols $61.87 vergleichbar; dort wird nur der letzte Versuch pro Task gezählt.
Reruns, und einer, der uns begünstigt. Neun Tasks werden mit einem späteren Lauf gewertet. Der letzte Lauf zählt, egal ob bestanden oder durchgefallen:
- Harness- oder Verifier-Fixes, 4 Tasks.
polyglot-c-pyhing pro Versuch ~300 s an einer interaktiventzdata-Abfrage, bis der HarnessDEBIAN_FRONTEND=noninteractivegesetzt hat.qemu-startupundqemu-alpine-sshwurden vom Agenten gelöst, aber der Verifier des Tasks (aufdebian:bullseye) konntecurl/sshpassnicht installieren, weil der End-of-Life-Security-Mirror 404 liefert. Jeder Lauf bekam deshalb 0. Der Harness entfernt diesen Mirror jetzt vor dem Verifier.extract-moves-from-videowurde nach einem CPU-Limit-Fix wiederholt und ist trotzdem durchgefallen. - Timeouts, 6 Tasks, Rerun mit
highReasoning:adaptive-rejection-sampler,cobol-modernization,extract-moves-from-video,make-doom-for-mips,query-optimize,schemelike-metacircular-eval. Das waren Agent-Timeouts, keine Infrastrukturschäden. Der Rerun ist also ein zweiter Versuch. Bei zwei Tasks änderte sich das Ergebnis zu „bestanden“ (adaptive-rejection-sampler,cobol-modernization), vier sind weiter durchgefallen. Ohne diese zwei liegt der Score bei 92.6% (75/81).
Jedes Feld ist ein versuchter Task; die 8 abgelehnten Tasks sind nicht gezeigt. Schraffierte Felder wurden mit einem späteren Lauf gewertet. Beim Darüberfahren wird die Task-ID angezeigt.
All task IDs and outcomes
bn-fit-modify— passedbuild-cython-ext— passedbuild-pmars— passedbuild-pov-ray— passedcaffe-cifar-10— passedcancel-async-tasks— passedchess-best-move— passedcircuit-fibsqrt— passedcode-from-image— passedcompile-compcert— passedconfigure-git-webserver— passedconstraints-scheduling— passedcount-dataset-tokens— passedcustom-memory-heap-crash— passeddb-wal-recovery— passeddistribution-search— passedextract-elf— passedfeal-differential-cryptanalysis— passedfeal-linear-cryptanalysis— passedfinancial-document-processor— passedfix-code-vulnerability— passedfix-git— passedfix-ocaml-gc— passedgcode-to-text— passedgit-leak-recovery— passedgit-multibranch— passedgpt2-codegolf— passedheadless-terminal— passedhf-model-inference— passedinstall-windows-3.11— passedkv-store-grpc— passedlarge-scale-text-editing— passedlargest-eigenval— passedllm-inference-batching-scheduler— passedlog-summary-date-ranges— passedmailman— passedmake-mips-interpreter— passedmcmc-sampling-stan— passedmerge-diff-arc-agi-task— passedmodel-extraction-relu-logits— passedmodernize-scientific-stack— passedmteb-leaderboard— passedmteb-retrieve— passedmulti-source-data-merger— passednginx-request-logging— passedopenssl-selfsigned-cert— passedoverfull-hbox— passedpath-tracing— passedpath-tracing-reverse— passedpolyglot-rust-c— passedportfolio-optimization— passedprove-plus-comm— passedpypi-server— passedpytorch-model-cli— passedpytorch-model-recovery— passedraman-fitting— passedregex-chess— passedregex-log— passedreshard-c4-data— passedrstan-to-pystan— passedsam-cell-seg— passedsanitize-git-repo— passedsparql-university— passedsqlite-db-truncate— passedsqlite-with-gcov— passedtorch-pipeline-parallelism— passedtorch-tensor-parallelism— passedtrain-fasttext— passedtune-mjcf— passedvideo-processing— passedwinning-avg-corewars— passedwrite-compressor— passedadaptive-rejection-sampler— passed, replacement runcobol-modernization— passed, replacement runpolyglot-c-py— passed, replacement runqemu-alpine-ssh— passed, replacement runqemu-startup— passed, replacement runextract-moves-from-video— failed, replacement runmake-doom-for-mips— failed, replacement runquery-optimize— failed, replacement runschemelike-metacircular-eval— failed, replacement run
Die vier Fehlschläge: schemelike-metacircular-eval (Timeout, lange Thinking-Turns), make-doom-for-mips (Timeout), extract-moves-from-video (Timeout: OCR von 951 Frames auf einer CPU) und query-optimize (falsche Antwort).
Vergleich. Die 78.9% (Claude Code, Opus 4.8) und 78.4% (Codex, GPT-5.6 Terra) auf unserer Seite sind Einträge im tbench.ai-Leaderboard über alle 89 Tasks mit mehreren Trials je Task. Es gelten dieselben Einschränkungen der Vergleichbarkeit wie unten, und Ablehnungen zählen dort als Fehlschläge. Der Abstand ist nur ein Anhaltspunkt.
Der Rest dieses Beitrags dokumentiert die früheren GPT-5.6 Sol-Läufe.
Frühere Läufe: GPT-5.6 Sol
Vor Opus 5.5 haben wir Terminal-Bench 2.1 zweimal auf denselben 89 Tasks mit GPT-5.6 Sol laufen lassen. Das Hauptergebnis war damals der Single-Model-Lauf: 79.8% (71/89), GPT-5.6 Sol auf xhigh, mit gesperrtem Review-Tool. Web fetch lässt das Lesen der Seiten weiterhin von Claude Haiku 4.5 erledigen ($4.17 der $46.87). Nichts in diesem Lauf prüft oder kontrolliert die Arbeit des Hauptmodells.
Der frühere Lauf vom 25–26 August hatte einen Review-Sub-Agent auf Claude Opus 5 eingeschaltet und kam auf 82.0% (73/89). Der Unterschied beträgt zwei Tasks bei 2.9× den Kosten, und die Tasks, die durch das Review hinzugewonnen wurden, waren die „Fast-geschafft“-Fälle: 1 von 2 Schachzügen, 3 von 4 Tests. Der größte Teil dieses Beitrags dokumentiert den früheren Lauf, weil nur er eine Ergebnistabelle pro Task hat. Der Lauf ohne Review nutzt denselben Harness, dieselbe Wertungsregel und dasselbe gepinnte Repository. Sein Ergebnisblatt listet jede Änderung und jeden Fehlschlag auf.
| Review aus (Hauptergebnis) | Review an | |
|---|---|---|
| Pass-Rate | 79.8% (71/89) | 82.0% (73/89) |
| Wilson-95%-Intervall | [70.3%, 86.8%] | [72.8%, 88.6%] |
| Modelle | GPT-5.6 Sol; Haiku 4.5 für web fetch | + Claude Opus 5 Review |
| Kosten, Promo / Liste | $46.87 / ~$89.6 | $134.51 / $188.33 |
| Zeitraum | 2–3 September 2026 | 25–26 August 2026 |
Die folgenden Abschnitte dokumentieren den Lauf mit Review von Terminal-Bench 2.1 vom 25–26 August 2026. Dieser Beitrag zeigt, wie die Zahl entstanden ist, damit man sie richtig lesen kann: Sie ist ein Systemergebnis unter einer genannten Rerun-Regel, keine offizielle Leaderboard-Einreichung und kein Score eines einzelnen Modells.
Alle Zahlen unten stammen aus dem gepinnten Ergebnisblatt im öffentlichen Benchmark-Repository. Die Links pinnen einen Commit, spätere Änderungen können also nicht unbemerkt ändern, was dieser Artikel beschreibt.
Das getestete System
Terminal-Bench gibt einem Agenten einen Task in einem isolierten Container — ein Projekt kompilieren, eine Datenbank wiederherstellen, einen Dienst konfigurieren, Code reparieren — und ein Verifier prüft den entstandenen Zustand. Was der Agent selbst als Erfolg meldet, spielt keine Rolle. Nur das Ergebnis des Verifiers zählt.
- 89 Task-IDs
- isolierte Docker-Umgebung
- sendet die Anweisung
- Edge führt im Container aus
- ausgeliefertes Modell in den Message-Metadaten geprüft
- review → Claude Opus 5
- explore, webfetch → Haiku 4.5
- ein finales Ergebnis pro Task
Zwei Details dieser Konfiguration sind für die Deutung wichtig.
Die 82.0% gehören zur ganzen Pipeline. Review und Exploration liefen innerhalb desselben Trials auf Anthropic-Modellen. Die Zahl lässt sich also nicht allein GPT-5.6 Sol zuschreiben. Der Lauf ohne Review oben isoliert diesen Effekt: 79.8%.
Das ausgelieferte Modell wurde geprüft, nicht angenommen. Der CLI-Header gibt nur das angeforderte Modell wieder. Die Lauf-Notizen verifizieren gpt-5.6-sol auf xhigh anhand der Provider-Metadaten, die an jeder Assistant-Message hängen.
Wertungsregel und die Ersatzläufe
Das Ergebnisblatt hält ein finales Ergebnis pro Task fest. Sechzehn Tasks wurden am 26 August wiederholt, nachdem ihr erster Versuch als durch Infrastrukturprobleme beeinträchtigt eingestuft wurde. Bei diesen Tasks ersetzt das Rerun-Ergebnis das ursprüngliche.
Jedes Feld ist ein Task. Schraffierte Felder wurden mit ihrem Ersatzlauf gewertet. Beim Darüberfahren wird die Task-ID angezeigt.
All task IDs and outcomes
bn-fit-modify— passedbuild-pmars— passedcancel-async-tasks— passedchess-best-move— passedcode-from-image— passedconfigure-git-webserver— passedconstraints-scheduling— passedcount-dataset-tokens— passedcrack-7z-hash— passeddb-wal-recovery— passeddistribution-search— passedextract-elf— passedfeal-differential-cryptanalysis— passedfeal-linear-cryptanalysis— passedfinancial-document-processor— passedfix-code-vulnerability— passedfix-git— passedfix-ocaml-gc— passedgcode-to-text— passedgit-leak-recovery— passedgit-multibranch— passedheadless-terminal— passedhf-model-inference— passedinstall-windows-3.11— passedkv-store-grpc— passedlarge-scale-text-editing— passedlargest-eigenval— passedllm-inference-batching-scheduler— passedlog-summary-date-ranges— passedmerge-diff-arc-agi-task— passedmodel-extraction-relu-logits— passedmodernize-scientific-stack— passedmteb-leaderboard— passedmteb-retrieve— passedmulti-source-data-merger— passednginx-request-logging— passedopenssl-selfsigned-cert— passedoverfull-hbox— passedpassword-recovery— passedpath-tracing— passedpath-tracing-reverse— passedpolyglot-c-py— passedpolyglot-rust-c— passedportfolio-optimization— passedprotein-assembly— passedprove-plus-comm— passedpypi-server— passedpytorch-model-cli— passedqemu-alpine-ssh— passedraman-fitting— passedregex-log— passedrstan-to-pystan— passedsanitize-git-repo— passedschemelike-metacircular-eval— passedsparql-university— passedsqlite-db-truncate— passedsqlite-with-gcov— passedtorch-tensor-parallelism— passedtune-mjcf— passedvulnerable-secret— passedwinning-avg-corewars— passedwrite-compressor— passedbreak-filter-js-from-html— passed, replacement runbuild-cython-ext— passed, replacement runbuild-pov-ray— passed, replacement runcaffe-cifar-10— passed, replacement runcobol-modernization— passed, replacement runcompile-compcert— passed, replacement runcustom-memory-heap-crash— passed, replacement rundna-insert— passed, replacement runmailman— passed, replacement runmake-mips-interpreter— passed, replacement runmcmc-sampling-stan— passed, replacement runfilter-js-from-html— failedgpt2-codegolf— failedmake-doom-for-mips— failedpytorch-model-recovery— failedqemu-startup— failedquery-optimize— failedregex-chess— failedreshard-c4-data— failedsam-cell-seg— failedtrain-fasttext— failedvideo-processing— failedadaptive-rejection-sampler— failed, replacement runcircuit-fibsqrt— failed, replacement rundna-assembly— failed, replacement runextract-moves-from-video— failed, replacement runtorch-pipeline-parallelism— failed, replacement run
Das ist weder All-Attempt-Genauigkeit noch Best-of-N. Der Ersatz gilt überall, wo ein Rerun existiert, unabhängig davon, welches Ergebnis besser war. 11 der 16 Ersatzläufe haben bestanden, 5 sind durchgefallen. Die Regel begünstigt das System trotzdem: Nur Tasks, deren erster Versuch als durch Infrastrukturprobleme beeinträchtigt eingestuft wurde, wurden wiederholt, und das Blatt hält deren ursprüngliche Ergebnisse nicht fest. Das Blatt zählt außerdem insgesamt 102 Trials bei 16 als Reruns markierten Tasks, eine Abweichung, die es nicht auflöst. Jeder Vergleich mit einem Protokoll, das alle Trials mittelt, muss beide Punkte berücksichtigen.
Die 16 Tasks, die mit einem Ersatzlauf gewertet wurden, sind: adaptive-rejection-sampler, break-filter-js-from-html, build-cython-ext, build-pov-ray, caffe-cifar-10, circuit-fibsqrt, cobol-modernization, compile-compcert, custom-memory-heap-crash, dna-assembly, dna-insert, extract-moves-from-video, mailman, make-mips-interpreter, mcmc-sampling-stan, torch-pipeline-parallelism. Fünf davon gehören zu den sechzehn finalen Fehlschlägen.
Statistische Präzision
Es wurde kein wiederholter voller Sweep gefahren, deshalb nennt das Blatt kein Intervall. Für einen einzelnen binomialen Anteil zeigt das Wilson-95%-Intervall, wie stark sich ein Ergebnis bei dieser Task-Anzahl bewegen kann:
mit , , .
Das Intervall ist illustrativ. Es setzt unabhängige Trials mit fester Erfolgswahrscheinlichkeit pro Task voraus und bildet weder die Ersatzregel noch die unterschiedliche Schwierigkeit der Tasks ab. Es zeigt aber die Größenordnung: Ein Abstand von ein paar Punkten zwischen zwei Einzel-Sweeps auf 89 Tasks liegt locker in diesem Bereich und ist für sich allein kein Beleg, dass ein System besser ist.
Womit sich die Zahl vergleichen lässt
Unsere Seite zeigt inzwischen unser Ergebnis vom 26. Oktober neben den Läufen von Claude Code und Codex vom 8. Oktober, alle von uns auf demselben Modell und denselben Tasks gemessen (siehe den Anfang dieses Beitrags). Als dieser Abschnitt geschrieben wurde, zeigte sie die tbench.ai-Leaderboard-Einträge, Claude Code mit 78.9% und Codex mit 78.4%, neben unserem Sol-Ergebnis. Die Tabelle unten beschreibt die Sol-Läufe gegen die Regeln des Leaderboards; dieselben Nicht-Äquivalenzen gelten für die Opus-5.5-Läufe.
| Dimension | tbench.ai-Leaderboard | Dieser Lauf |
|---|---|---|
| Genauigkeit | Erfolge ÷ alle Trials; Reruns eingemittelt | ein finales Ergebnis pro Task; das Rerun-Ergebnis ersetzt den ursprünglichen Versuch |
| Trials pro Task | ≥ 5 bei gelisteten Einträgen | 1, mit 16 Tasks, die mit einem Ersatzlauf gewertet wurden |
| Kosten | Summe aller Trials | nur der letzte Versuch pro Task |
| Token-Zahl | input + output; Cache-Tokens ausgenommen | alle vier Klassen, Cache-Reads eingeschlossen |
| Modell | wie eingereicht, ein Eintrag pro Modell | 79.8%: GPT-5.6 Sol, Haiku für web fetch · 82.0%: + Opus-Review |
Nach der Regel des Leaderboards — alle Versuche eingemittelt, statt das Rerun-Ergebnis als Ersatz einzusetzen — würden beide Läufe niedriger abschneiden (unter 79.8% bzw. 82.0%), wenn die ersetzten Versuche als Fehlschläge zählen, und die Kosten würden mit der Trial-Anzahl skaliert. Die Vergleichbarkeits-Notizen im Repository rechnen die Anpassungen durch.
Ein Terminal-Benchmark misst außerdem nur einen schmalen Ausschnitt dessen, was ein Agent-Produkt tut. Er sagt nichts über E-Mail, CRM-Arbeit, Browser-Tasks, Berechtigungen oder Team-Workflows. Dazu siehe TODO for AI vs Claude Code, vs Codex oder die Vergleichsübersicht.
Kosten des Laufs mit Review: drei Modelle, vier Token-Klassen
Die Kosten werden aus den Usage-Reports der Provider für den letzten Versuch jedes Tasks berechnet, einschließlich der Sub-Agent-Todos, die von jedem Trial verlinkt sind. Verworfene, durch Infrastrukturprobleme beeinträchtigte Versuche werden nicht bepreist.
| Modell | Rolle | Input | Output | Cache Read | Cache Write |
|---|---|---|---|---|---|
| GPT-5.6 Sol | Hauptschleife | 7.65M | 0.95M | 144.94M | 0 |
| Claude Opus 5 | Review | ~0 | 1.74M | 24.31M | 2.68M |
| Claude Haiku 4.5 | explore, webfetch | 0.24M | 0.50M | 18.98M | 2.96M |
| Modell | $/Mtok — in / out / cache read / cache write | Kosten | Pro Task |
|---|---|---|---|
| GPT-5.6 Sol | 2 / 10 / 0.2 / 2.5 (Promo) | $53.82 | $0.60 |
| Claude Opus 5 | 5 / 25 / 0.5 / 6.25 | $72.37 | $0.81 |
| Claude Haiku 4.5 | 1 / 5 / 0.1 / 1.25 | $8.32 | $0.09 |
| Summe | $134.51 | $1.51 |
Drei Beobachtungen ergeben sich direkt aus der Tabelle.
- Der Review-Sub-Agent kostet mehr als das Modell, das getestet wird — $72.37 gegen $53.82, aus etwa 50 Review-Aufrufen, fast ausschließlich Opus-Output und Cache-Writes. Mit ausgeschaltetem Review (der 79.8%-Lauf) sank die Summe auf $46.87.
- Cache-Reads machen 93% aller gesendeten Tokens aus. Eine Agent-Schleife schickt ihren Kontext in jedem Turn erneut mit. Eine Token-Zahl, die nur
input + outputmeldet — wie die Token-Spalte des Leaderboards — beschreibt einen kleinen Teil des Traffics, den Provider abrechnen. - Der Preis ist ein Parameter, die Tokens sind die Messung. Zum vollen Listenpreis von GPT-5.6 Sol (4 / 20 / 0.4 / 5) wird die Summe zu $188.33, also $2.12 pro Task statt $1.51. Unser eigenes Billing-Ledger ist bewusst nicht die Kernzahl: Es enthält Promo-Rabatte, die außerhalb niemand reproduzieren kann.
Die sechzehn Fehlschläge
adaptive-rejection-sampler, circuit-fibsqrt, dna-assembly, extract-moves-from-video, filter-js-from-html, gpt2-codegolf, make-doom-for-mips, pytorch-model-recovery, qemu-startup, query-optimize, regex-chess, reshard-c4-data, sam-cell-seg, torch-pipeline-parallelism, train-fasttext, video-processing.
Elf sind im ursprünglichen Sweep durchgefallen, fünf in einem Ersatzlauf. Das Blatt hält Ergebnisse fest, keine Ursachen, und dieser Beitrag stuft keinen davon nachträglich als Infrastrukturproblem ein.
Die Konfiguration reproduzieren
Öffentliche Inputs:
- Ergebnisblatt, 8. Oktober — alle 89 Ergebnisse der drei Harnesses, Zählregel, Job-IDs
- Ergebnisblatt, Sol-Läufe — Token- und Preistabellen
- Task-Liste
- Harbor-Adapter
- Skript zur Token-Abrechnung
Der Adapter ruft ein gehostetes Backend auf und nutzt einen im Account konfigurierten Agenten namens app. Modellzugang, Reasoning-Einstellung, Sub-Agent-Modelle und Tool-Berechtigungen liegen in diesem Account, nicht im Repository. Ein Clone ist also ein Startpunkt, keine hermetisch reproduzierbare Ausführung. Nimm einen dedizierten Benchmark-Account und einen Docker-Host ohne andere, nicht benötigte Zugangsdaten. Ein Aufruf für einen einzelnen Task:
git clone https://github.com/todoforai/benchmarks.git
cd benchmarks && git checkout 0133572
cd terminal-bench
python3 -m venv .venv && . .venv/bin/activate && pip install -e .

: "${TODOFORAI_API_KEY:?Set a dedicated benchmark API key first}"
export TODOFORAI_API_KEY

harbor run \
  -d "terminal-bench/terminal-bench-2-1" \
  --agent-import-path "todoforai_tbench:TODOforAIHarborAgent" \
  -m "anthropic:anthropic/claude-opus-5.5" \
  -i "terminal-bench/openssl-selfsigned-cert" \
  --job-name "tb21-single-task" \
  --max-retries 0 \
  --yes -n 1
Das Flag -m wählt das Hauptmodell; Reasoning-Stufe, Refusal-Fallback und Tool-Berechtigungen kommen aus dem Agenten. Das Template terminal-bench-89 legt diesen Agenten mit der Konfiguration vom 8. Oktober an; für den Lauf vom 26. Oktober nur device:BASH und device:tfa-cat erlauben (kein Read-Tool), TODO for AI 1.0.11 / Bridge 1.5.71 (siehe das Ergebnisblatt vom 26. Oktober). Prüfe das bediente Modell in den zurückgegebenen Message-Metadaten, bevor du einem Sweep traust.
Für einen Lauf, der mit dem Leaderboard verglichen werden soll: Dependency-Versionen und Agent-Einstellungen vor dem Start festlegen, jeden Versuch behalten, die Retry-Regel vorab erklären und die All-Trial-Genauigkeit getrennt von jeder Ersatzlauf-Diagnose berichten.