
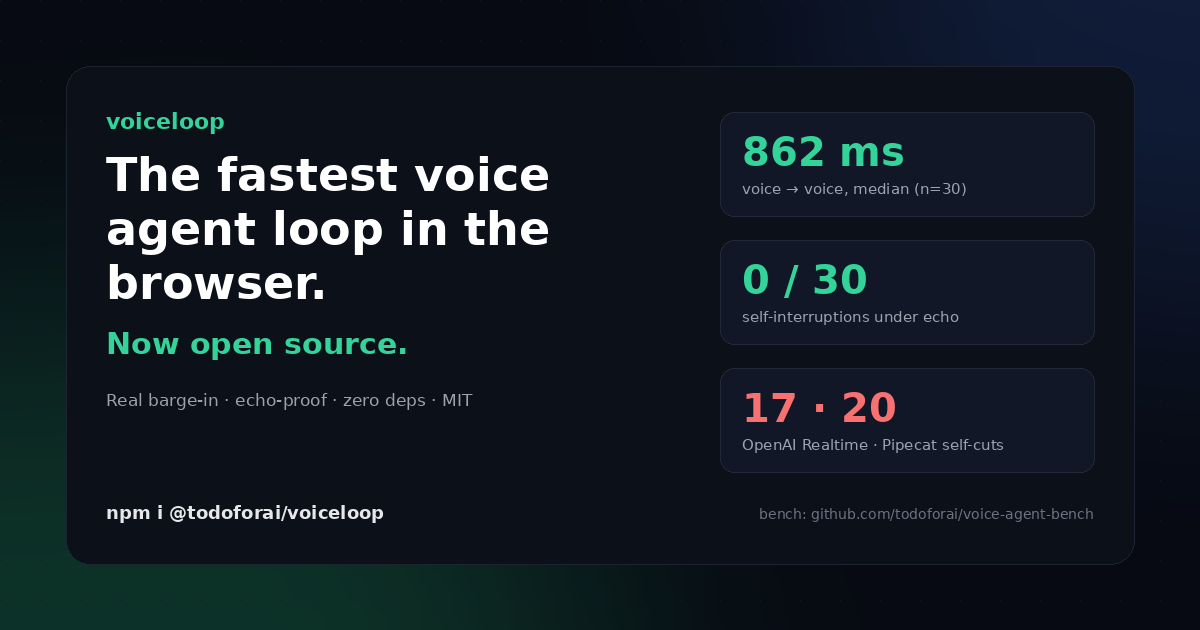
Mostantól bárki beépítheti a saját termékébe a legjobb hangügynököt. Az első helyezett hangalapú feldolgozási ciklus nyílt forráskódú, és az ezt bizonyító benchmark is publikus.
- Demó, kulcsok nélkül: todoforai.github.io/voiceloop
- Könyvtár: github.com/todoforai/voiceloop —
npm i @todoforai/voiceloop - Benchmark: github.com/todoforai/voice-agent-bench
Miért építettük meg
A TODOforAI-ba böngészőben akartuk a gördülékeny JARVIS-élményt: beszélsz, egy másodpercen belül válaszol, közbevágsz egy mondat közepén, és egyszerűen elhallgat. Nem találtunk olyan stacket, ami ezt rendesen tudta volna. A zárt API-k közel jártak hozzá, de nem a mieink voltak. A nyílt keretrendszerek a felhasználó szavába vágtak, vagy ami még rosszabb, meghallották a saját hangjukat a hangszórón át, és megszakították magukat.
2026 van. Ez már megoldott problémának kellene lennie. Megoldottuk, és az egészet publikáltuk: a ciklust, a számokat és a mérőrendszert, amivel a számokat kaptuk.
Mi az a voiceloop
Egy függőségmentes JavaScript-könyvtár, ami a teljes ciklust futtatja a böngészőben: VAD → STT → LLM → TTS, a nehéz részeket már megoldva.
- Valódi közbevágás (barge-in) — az ügynök beszédében nem szereplő, újonnan felismert szavakra reagál, nem a mikrofon energiájára, ezért az ügynök saját hangja, ami beszivárog a mikrofonba, soha nem szakítja félbe az ügynököt.
- Önvisszhang-szűrés — egy szóegyeztető szűrő összeveti, amit a mikrofon hall, azzal, amit az ügynök éppen mond. 0 önmegszakítás 30 visszhangos körben, teljesen kikapcsolt visszhangcsillapítással.
- Az első hang egy másodpercen belül — a TTS az 1. mondatot mondja, miközben az LLM még a 2.-at írja, és az LLM-hívás spekulatívan elindul a beszédvégi szünet alatt.
- Local-first — a Silero VAD és a Piper TTS WASM-ként fut a böngészőben. Ingyenes, nincs szükség felhős oda-vissza kommunikációra.
- Sorba rendezett körök — gyors egymásutáni körök, eszközeredmények, várakoztatások és visszajátszások soha nem beszélhetnek egymásra. Ezt 178 teszt garantálja.
Minden cserélhető: bármilyen OpenAI-kompatibilis LLM, négy STT-szolgáltató (Web Speech, ElevenLabs Scribe, Deepgram Flux, Speechmatics), cserélhető TTS (Piper helyben, ElevenLabs felhőből, vagy a saját megoldásod).
import { VoiceAgent, unlockAudio } from '@todoforai/voiceloop';

const agent = new VoiceAgent({
  llmUrl: '/api/chat/completions',   // any OpenAI-compatible endpoint, behind your proxy
  model: 'claude-haiku-4-5',
  persona: 'You are a friendly cooking assistant.',
  onEvent: (e) => { if (e.type === 'assistant') render(e.text); },
});

button.onclick = async () => { unlockAudio(); await agent.start(); };
Ennyi a teljes integráció.
A számok
A hangalapú AI területén a késleltetési állításokat általában maguk a gyártók közlik, és nem reprodukálhatók. Nem akartunk még egyet hozzátenni, ezért megépítettük a voice-agent-bench nevű feketedobozos mérőrendszert. Egy szkriptelt „ember” (bájtszinten azonos, előre legenerált beszéd) beszél egy virtuális mikrofonba, rögzítjük az ügynök hangszórókimenetét, és minden pontszám csak a hangból származik. Nem kell hozzá integráció: bármelyik ügynök mérhető, amelyik hangot ad ki, a zártak is.
Minden rendszer ugyanazokat a szkriptelt beszélgetéseket kapja, és ahol a rendszer engedi, ugyanazt a fix mock LLM-et (300ms TTFT), így az összehasonlítás a hangciklust méri, nem a modellt. 5 beszélgetés × 6 kör összesítve, n=30, medián és p95 — az egyes futások ±300ms-ot ingadoznak, ezért nem érdemes őket kiírni.
Small talk — ugyanaz a mock LLM, 5×6 kör összesítve
| konfiguráció | hang→hang | p95 | leállási idő közbevágáskor | akadások |
|---|---|---|---|---|
| OpenAI Realtime (speech-to-speech, saját LLM) * | 866ms | 1644 | 429ms | 20 |
| voiceloop · deepgram + ElevenLabs flash | 862ms | 1067 | 944ms | 16 |
| voiceloop · deepgram + Piper (ingyenes, helyi TTS) | 974ms | 1287 | 1463ms | 19 |
| Pipecat 1.8.1 · deepgram + EL flash | 1046ms | 3573 | 542ms | 14 |
| ElevenLabs ConvAI | 1454ms | 1632 | 1042ms | 8 |
| voiceloop · EL Scribe + EL flash | 1562ms | 1855 | 1566ms | 12 |
| voiceloop · Speechmatics + EL flash | 1706ms | 2069 | 1046ms | 17 |
| voiceloop · webspeech + Piper (kulcs nélkül) | 2113ms | 2607 | 1257ms | 30 |
Különböző helyzetekben
| rendszer | tiszta | habozás | a felhasználó szavába vágott | visszhang | megszakította magát |
|---|---|---|---|---|---|
| OpenAI Realtime * | 870 | 1290 | 0 (130 ms-on belül átadja a szót) | 790 | 17/30 |
| voiceloop · deepgram + EL flash | 860 | 1400 | 0 (420ms) | 930 | 0 |
| voiceloop · deepgram + Piper | 970 | 1400 | 0 | — | — |
| Pipecat | 1050 | 1290 | 2 (200ms) | 1320 | 20/30 |
| ElevenLabs ConvAI | 1450 | 1810 | 0 (490ms) | 1410 | 0 |
* A Realtime speech-to-speech, ezért nem használhatja a fix mock LLM-et, így a sora nem teljesen azonos alapon összehasonlítható.
Hogyan olvasd
Tiszta hang: a Deepgram Flux + ElevenLabs flash párosítású voiceloop a leggyorsabb konfiguráció, amit mértünk, 862ms mediánnal — és a p95-je (1067 ms) messze a legalacsonyabb a táblázatban. A Pipecat 3573ms-os p95-je ugyanazokkal a szolgáltatókkal azt jelenti, hogy húsz körből egy több mint három másodpercig tart. Az ingyenes, teljesen helyi Piper-útvonal 974ms-on végez, felhős TTS nélkül.
A visszhang az a hiba, ami szétválasztja a stackeket. Ha minden rendszernek visszaadjuk a saját hangját a mikrofonon át (−15dB, 30ms késleltetés, AEC nélkül — ezt csinálja egy laptop bekapcsolt hangszóróval), a többi gyors stack a saját hangját a felhasználó hangjaként érzékeli, és megszakítja a saját válaszait: a Pipecat 30 körből 20-ban, az OpenAI Realtime 17-ben. A voiceloop nulla alkalommal szakította meg magát, és a visszhangos köröket 930ms-on futtatta — a tiszta hanggal azonos szinten. A szószintű visszhangszűrés nem növeli a késleltetést, miután a szűrő helyesen osztályozta a bemenetet.
Habozás: aki mondat közben megáll, abba nem szabad belebeszélni. A Pipecat kivételével minden stack kivár; a voiceloop 30 habozásos körből 2-ben kezd beszélni, majd 420 ms-on belül átadja a szót.
A kulcs nélküli alapbeállítás őszintén megmutatja az árát. A böngészős Web Speech + Piper sehol nem kér fiókot, és ez futtatja a demót, de körülbelül 1,2 másodperccel lassabban zár le egy kört, mint a felhős STT (2113ms). A fenti számokhoz válassz pipeline STT-szolgáltatót.
A teljes, helyzetenkénti táblázatok, a módszertan és az újrafuttatás lépései: results/RESULTS.md.
Több száz konfiguráció, hogy neked ne kelljen
A fenti sorok a túlélők. Mögöttük több száz futás áll STT-szolgáltatókkal, TTS-motorokkal, VAD-küszöbökkel, beszédvégi debounce-értékekkel, minimális közbevágás-hosszakkal, prefetch-stabilitási ablakokkal és visszhang-egyezési küszöbökkel. Minden lényeges beállítás elérhető a src/tuning.js fájlban, az alapértékek pedig azok, amik nyertek a benchmarkon. Azokat a határeseteket, amelyeket egyébként egyesével, éles hibákon keresztül fedeznél fel — az ügynök, ami megszakítja magát, az eszközhívás, ami olyan mondatra indul el, amit a felhasználó még javított, a beragadt eszköz, ami megállítja a következő kört — már kezeltük, és regressziós tesztek védik őket.
Próbáld ki, használd, múld felül
- Próbáld ki: todoforai.github.io/voiceloop — 20 másodperc, kulcsok nélkül, a böngészőben fut.
- Használd:
npm i @todoforai/voiceloop— MIT, nulla függőség. Irányítsd bármilyen OpenAI-kompatibilis végpontra, és kösd be az eszközeidet. - Múld felül: a benchmark feketedobozos és publikus. Ha a te stacked jobb, add hozzá — az ADDING_A_SUT.md a szerződés. Közzétesszük az eredményedet.
Ez a hangalapú feldolgozási ciklus fut a TODOforAI JARVIS-ában is; a könyvtár és a termék közti integrációs többletmunka nulla, és pontosan ez a lényeg. Mindenki számára elérhetővé kell tenni a legjobb hangalapú feldolgozási ciklust. Csillagozd, oszd meg, járulj hozzá — maradjon a legjobb nyílt forráskódú.