
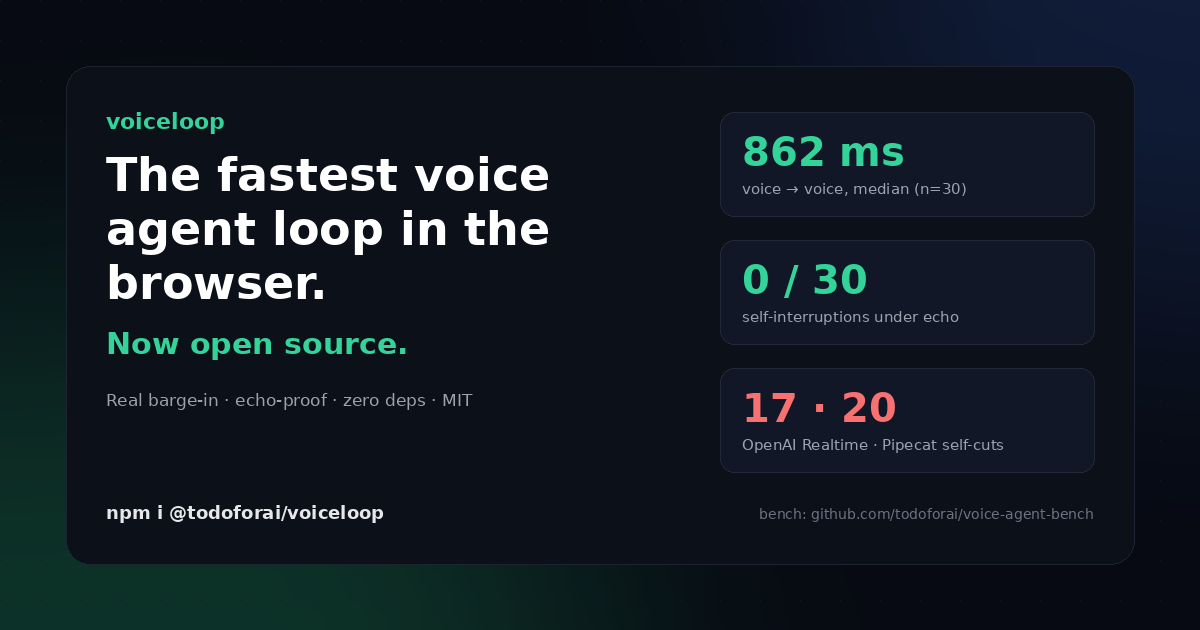
Jeder kann jetzt den besten Voice Agent in sein eigenes Produkt einbauen. Der Loop auf Platz 1 ist Open Source, und der Benchmark, der das belegt, ist öffentlich.
- Demo, ohne Keys: todoforai.github.io/voiceloop
- Bibliothek: github.com/todoforai/voiceloop —
npm i @todoforai/voiceloop - Bench: github.com/todoforai/voice-agent-bench
Warum wir es gebaut haben
Wir wollten das flüssige JARVIS-Gefühl im Browser für TODOforAI. Du sprichst, es antwortet innerhalb einer Sekunde. Du unterbrichst es mitten im Satz, und es hört einfach auf. Wir haben keinen Stack gefunden, der das sauber macht. Geschlossene APIs kamen nah ran, waren aber nicht unsere. Die offenen Frameworks sind dem Nutzer ins Wort gefallen. Oder, schlimmer, sie haben ihre eigene Stimme über die Lautsprecher gehört und sich selbst unterbrochen.
Es ist 2026. Das sollte ein gelöstes Problem sein. Also haben wir es gelöst und alles veröffentlicht: den Loop, die Zahlen und das Rig, das die Zahlen erzeugt hat.
Was voiceloop ist
Eine JavaScript-Bibliothek ohne Abhängigkeiten, die den ganzen Loop im Browser ausführt: VAD → STT → LLM → TTS. Die schwierigen Teile sind schon gelöst.
- Echtes Barge-in — löst bei transkribierten neuen Wörtern aus, nicht bei Mikrofonenergie. Die eigene Stimme des Agents, die ins Mikro gelangt, unterbricht ihn deshalb nie.
- Filter gegen Selbst-Echo — ein Wortabgleich-Filter vergleicht, was das Mikro hört, mit dem, was der Agent gerade sagt. 0 Selbstunterbrechungen in 30 echogekoppelten Turns bei komplett abgeschalteter Echounterdrückung.
- Erstes Audio unter einer Sekunde — TTS spricht Satz 1, während das LLM noch Satz 2 schreibt. Der LLM-Call startet spekulativ schon in deiner Pause am Ende des Turns.
- Local-first — Silero VAD und Piper TTS laufen als WASM im Tab. Kostenlos, keine Cloud-Roundtrips.
- Serialisierte Turns — schnell aufeinanderfolgende Turns, Tool-Ergebnisse, Holds und Replays können niemals gleichzeitig sprechen oder einander ins Wort fallen. Abgesichert durch 178 Tests.
Alles ist austauschbar: jedes OpenAI-kompatible LLM, vier STT-Anbieter (Web Speech, ElevenLabs Scribe, Deepgram Flux, Speechmatics), austauschbares TTS (Piper lokal, ElevenLabs Cloud oder dein eigenes).
import { VoiceAgent, unlockAudio } from '@todoforai/voiceloop';

const agent = new VoiceAgent({
  llmUrl: '/api/chat/completions',   // any OpenAI-compatible endpoint, behind your proxy
  model: 'claude-haiku-4-5',
  persona: 'You are a friendly cooking assistant.',
  onEvent: (e) => { if (e.type === 'assistant') render(e.text); },
});

button.onclick = async () => { unlockAudio(); await agent.start(); };
Das ist die ganze Integration.
Die Zahlen
Latenzangaben bei Voice AI beruhen meist auf Eigenangaben und sind nicht reproduzierbar. Wir wollten nicht noch eine davon liefern. Deshalb haben wir voice-agent-bench gebaut: ein Black-Box-Rig. Eine geskriptete „Person“ (byte-identische, vorab generierte Sprache) spricht in ein virtuelles Mikro, die Lautsprecher-Ausgabe des Agents wird aufgenommen, und jeder Score wird allein aus dem Audio abgeleitet. Keine Integration nötig — jeder Agent, der Ton macht, lässt sich messen, auch geschlossene.
Jedes System bekommt dieselben geskripteten Gespräche und, wo das System es zulässt, dasselbe feste Mock-LLM (300ms TTFT). So misst der Vergleich nur den Voice-Loop, nicht das Modell. 5 Gespräche × 6 Turns gepoolt, n=30, Median und p95. Einzelne Läufe schwanken um ±300ms und sind es nicht wert, veröffentlicht zu werden.
Smalltalk — gleiches Mock-LLM, 5×6 Turns gepoolt
| Konfiguration | Voice→Voice | p95 | Barge-in-Stopp | Hänger |
|---|---|---|---|---|
| OpenAI Realtime (Speech-to-Speech, eigenes LLM) * | 866ms | 1644 | 429ms | 20 |
| voiceloop · deepgram + ElevenLabs flash | 862ms | 1067 | 944ms | 16 |
| voiceloop · deepgram + Piper (kostenlos, lokales TTS) | 974ms | 1287 | 1463ms | 19 |
| Pipecat 1.8.1 · deepgram + EL flash | 1046ms | 3573 | 542ms | 14 |
| ElevenLabs ConvAI | 1454ms | 1632 | 1042ms | 8 |
| voiceloop · EL Scribe + EL flash | 1562ms | 1855 | 1566ms | 12 |
| voiceloop · Speechmatics + EL flash | 1706ms | 2069 | 1046ms | 17 |
| voiceloop · webspeech + Piper (ohne Key) | 2113ms | 2607 | 1257ms | 30 |
Szenarioübergreifend
| System | sauber | Zögern | trotz sprechendem Nutzer weitergeredet | Echo | unterbrach sich selbst |
|---|---|---|---|---|---|
| OpenAI Realtime * | 870 | 1290 | 0 (gibt nach 130 ms nach) | 790 | 17/30 |
| voiceloop · deepgram + EL flash | 860 | 1400 | 0 (420ms) | 930 | 0 |
| voiceloop · deepgram + Piper | 970 | 1400 | 0 | — | — |
| Pipecat | 1050 | 1290 | 2 (200ms) | 1320 | 20/30 |
| ElevenLabs ConvAI | 1450 | 1810 | 0 (490ms) | 1410 | 0 |
* Realtime ist Speech-to-Speech und kann das feste Mock-LLM nicht nutzen. Die Zeile ist deshalb nicht ganz vergleichbar.
So liest du es
Sauberes Audio: voiceloop mit Deepgram Flux + ElevenLabs flash ist die schnellste Konfiguration, die wir gemessen haben: 862ms im Median. Und der p95-Wert (1067 ms) ist mit großem Abstand der niedrigste in der Tabelle. Pipecats p95 von 3573ms mit denselben Anbietern heißt: Jeder zwanzigste Turn dauert über drei Sekunden. Der kostenlose, komplett lokale Piper-Pfad landet bei 974ms, ganz ohne Cloud-TTS.
Echo ist der Fehler, der die Stacks trennt. Gib jedem System seine eigene Stimme über das Mikro zurück (−15dB, 30ms Verzögerung, kein AEC — das passiert auf einem Laptop mit eingeschalteten Lautsprechern wirklich). Dann halten die anderen schnellen Stacks ihre eigene Stimme für die des Nutzers und unterbrechen ihre eigenen Antworten: Pipecat bei 20 von 30 Turns, OpenAI Realtime bei 17. voiceloop hat sich null-mal selbst unterbrochen und echogekoppelte Turns mit 930ms gefahren — gleichauf mit sauberem Audio. Wortbasierte Echofilterung kostet keine Latenz, sobald sie richtig klassifiziert.
Zögern: Ein Nutzer, der mitten im Satz pausiert, sollte nicht übersprochen werden. Jeder Stack außer Pipecat hält sich zurück. voiceloop redet in 2 von 30 Zögern-Turns los und gibt innerhalb von 420ms nach.
Der Zero-Key-Default ist ehrlich, was er kostet. Browser Web Speech + Piper braucht nirgends einen Account und treibt die Demo an. Er braucht aber ~1.2s länger, um einen Turn abzuschließen, als Cloud-STT (2113ms). Nimm für die Zahlen oben einen Pipeline-STT-Anbieter.
Vollständige Tabellen pro Szenario, Methodik und Schritte zur Reproduktion: results/RESULTS.md.
Hunderte Konfigurationen, damit du sie nicht durchprobieren musst
Die Zeilen oben sind die Überlebenden. Dahinter stehen Hunderte Läufe über STT-Anbieter, TTS-Engines, VAD-Schwellen, End-of-Turn-Debounces, Mindestlängen für Barge-in, Stabilitätsfenster fürs Prefetch und Schwellen für den Echo-Abgleich. Jeder Regler, der etwas bewirkt hat, steckt in src/tuning.js. Die Standardwerte entsprechen den Einstellungen, die im Benchmark am besten abgeschnitten haben. Die Randfälle, die du sonst nach und nach als Produktionsbugs entdecken würdest, sind schon behandelt und mit Regressionstests abgesichert: der Agent, der sich selbst unterbricht, Tool-Calls, die ausgelöst werden, obwohl der Nutzer seinen Satz noch ergänzt, und ein hängendes Tool, das den nächsten Turn blockiert.
Ausprobieren, nutzen, schlagen
- Ausprobieren: todoforai.github.io/voiceloop — 20 Sekunden, keine Keys, läuft in deinem Tab.
- Nutzen:
npm i @todoforai/voiceloop— MIT, keine Abhängigkeiten. Richte die Bibliothek auf einen beliebigen OpenAI-kompatiblen Endpoint aus und binde deine Tools ein. - Schlagen: Der Bench ist Black-Box und öffentlich. Wenn dein Stack besser ist, trag ihn ein — ADDING_A_SUT.md ist der Vertrag. Wir veröffentlichen die Zeile.
Das ist der Voice-Loop in JARVIS von TODOforAI. Der Integrationsaufwand zwischen Bibliothek und Produkt ist null, und genau das ist der Punkt. Jeder sollte den besten Voice-Loop haben. Gib einen Stern, teil es, trag bei — lass uns den besten Loop Open Source halten.