
„Ein KI-Assistent, der sich alles merkt“ ist eine Suche mit einem simplen Wunsch dahinter: nicht mehr alles neu erklären müssen. Wer du bist, wie du am liebsten arbeitest, was letzten Monat entschieden wurde, wie der Deploy abläuft.
Die Produkte, die das versprechen, behalten sehr unterschiedliche Dinge. Dieser Post sagt, was jedes davon tatsächlich speichert, wo du es sehen kannst und wofür es taugt. Agent Memory im Glossar liefert das Vokabular; das hier ist der Praxisleitfaden.
Offenlegung: TODO for AI ist unser Produkt. Wir bauen ein Memory-System und messen es öffentlich im Benchmark; dort stehen die Zahlen und die Einschränkungen.
Vier Arten von „merkt sich“
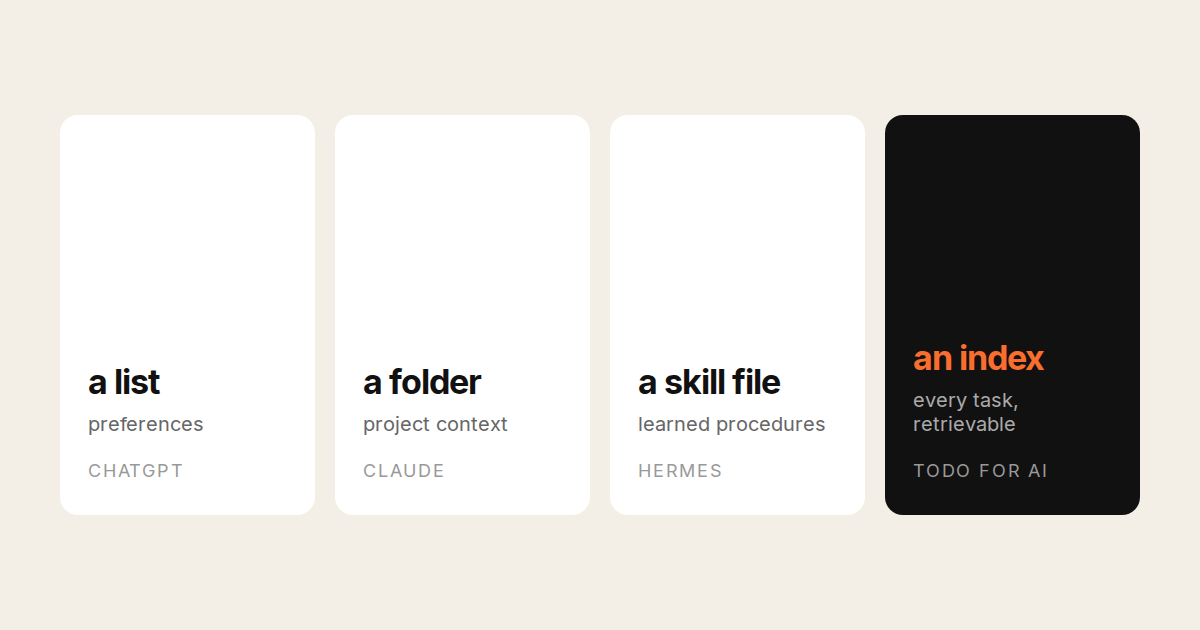
Präferenzen. Eine kurze Liste mit Fakten über dich, aus Chats extrahiert: Name, Job, der Ton, den du magst, Projekte, die du erwähnst. Klein, editierbar, in jede Unterhaltung eingespielt. Günstig und nützlich. Vergisst alles, was nicht nach einem Fakt über dich aussah.
Projektkontext. Dateien und Anweisungen, die du an einen Workspace hängst, plus das, was in diesem Workspace passiert ist. Merkt sich das Projekt, aber nicht projektübergreifend Informationen über dich.
Gelernte Abläufe. Der Agent schreibt auf, wie er eine Aufgabe gelöst hat, und nutzt die Notiz beim nächsten Mal. Merkt sich das Wie, wird durch Nutzung besser und ist nur so gut wie das, was er aufgeschrieben hat.
Alles, abrufbar. Jede vergangene Aufgabe und Nachricht ist indexiert. Ein Retrieval-Schritt holt bei einer neuen Aufgabe den passenden Ausschnitt innerhalb eines Token-Budgets. Merkt sich, was entschieden wurde, wann, und wodurch es abgelöst wurde. Aufwendig, das gut zu bauen; die einzige Art, die „Was haben wir im August zu X entschieden?“ beantworten kann.
Die meisten Produkte machen die ersten beiden. Zwei auf dieser Liste machen die letzten beiden.
Die Produkte
ChatGPT
Präferenzen plus Rückgriff auf den Chatverlauf. „Memory“ ist eine Liste, die du in den Einstellungen lesen und löschen kannst; gespeicherte Erinnerungen sind Fakten über dich und deine Präferenzen. Der Rückgriff auf den Chatverlauf lässt es auf frühere Unterhaltungen zugreifen. Gut für Ton und persönliche Fakten. Kein Protokoll erledigter Arbeit, und nichts außerhalb des Chats wird gemerkt.
Claude
Präferenzen, Projektkontext und der Session-Zustand von Cowork. Projects enthalten Dateien und Anweisungen pro Workspace; Memory fasst in kostenpflichtigen Tarifen über Chats hinweg zusammen. Claude Code ergänzt CLAUDE.md-Dateien im Repo. Das ist Projektkontext, den du selbst schreibst, und genau deshalb die verlässlichste Art von Memory auf dieser Liste: Es ist eine Datei, die du kontrollierst.
Hermes Agent
Gelernte Abläufe, ernsthaft umgesetzt. Hermes erstellt Skills auf Grundlage erledigter Aufgaben, verfeinert sie beim nächsten Lauf und führt ein mehrschichtiges Memory mit Session-Suche und User-Modelling. Self-hosted, das Memory liegt also auf deiner Platte und du kannst es einsehen. Die beste „wird durch Nutzung besser“-Story hier. Es ist ein Chat-Thread-Agent, er merkt sich also, was in Threads passiert ist. Vergleich.
TODO for AI
Alles, abrufbar. Jede vergangene Aufgabe und Nachricht ist indexiert und für den Agenten durchsuchbar, mit kombiniertem lexikalischem und semantischem Retrieval. Davon getrennt bringt in privaten Unterhaltungen ein Live-Memory-Block mit Token-Budget zu Beginn einer Aufgabe eine destillierte Auswahl in den Prompt. Dazu gibt es eine Ebene für Notizen und Abläufe, in die der Agent schreiben kann, adressiert über Source und Ref. So sind „Deploy-Ablauf“ und „Entschieden: keine Gedankenstriche in öffentlichen Texten“ dauerhafte Fakten statt glücklicher Treffer.
Die Retrieval-Engine ist als livemem Open Source: 94.7% auf LoCoMo bei 5.0K Kontext-Tokens pro Frage. Answerer, Judge und Kontext-Budget sind veröffentlicht, weil sie den Score stärker beeinflussen als das Memory selbst. Multi-Hop ist mit 81.2% die schwache Kategorie.
Wo es schwächer ist: Notizen und Live-Memory gelten pro Nutzer, nicht als geteilter Team-Pool. Die Suche im Aufgabenverlauf deckt die Projekte ab, auf die du Zugriff hast; private Aufgaben sind ausgenommen. Retrieval ist nur so gut wie das, was aufgeschrieben wurde. Eine Entscheidung in einem Voice-Call, bei dem der Agent nicht dabei war, steckt nicht drin. Und ein gesättigter Benchmark ist keine Garantie für deine Daten.
Im Vergleich
| Präferenzen | Projektkontext | Gelernte Abläufe | Jede vergangene Aufgabe, abrufbar | Wo es liegt | |
|---|---|---|---|---|---|
| ChatGPT | Ja, editierbare Liste | Projects | Nein | Rückgriff auf den Chatverlauf | OpenAI |
| Claude | Ja | Projects, CLAUDE.md | Nein | Nein | Anthropic, dein Repo |
| Hermes Agent | Ja | Pro Thread | Ja, selbst geschriebene Skills | Session-Suche | Deine Platte |
| TODO for AI | Ja, Notizen-Ebene | Pro Projekt | Notizen und Abläufe | Ja, durchsuchbare Historie | Dein Account, offene Engine |
So prüfst du, was ein Assistent sich merkt
Drei Tests, je eine Minute.
- Sag ihm eine Präferenz, starte eine neue Session und schau, ob er sie sich gemerkt hat. Jedes Produkt auf der Liste besteht das.
- Triff in einer Aufgabe eine Entscheidung und frag drei Aufgaben später danach. Produkte, die nur Präferenzen speichern, fallen durch. Hier fängt Retrieval an zu zählen.
- Ändere die Entscheidung und frag dann, welche gerade gilt. Der harte Test. Widersprüchliche Updates werden in den Benchmarks nicht ausreichend abgedeckt, aber genau solche widersprüchlichen Aktualisierungen machen echte Arbeit aus. Wenn er mit der alten Entscheidung antwortet, ist das Memory ein Haufen, kein Protokoll.
Mach den dritten Test, bevor du einem von ihnen ein längerfristiges Projekt anvertraust, uns eingeschlossen.