
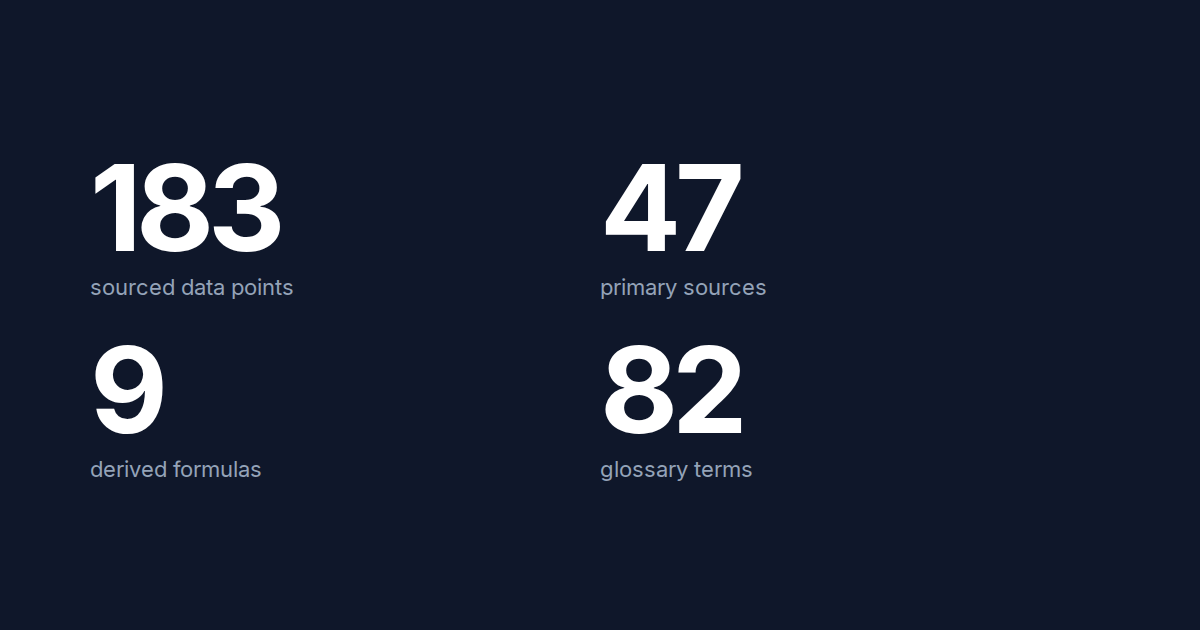
Három referenciaoldal áll az időrendi hírfolyamon kívül, és ezeket nem keltezzük, hanem karbantartjuk: két statisztikai gyűjtőoldal és egy szószedet. Ez a poszt azt írja le, hogyan épülnek fel. Így az olvasó tudja, mit jelent egy szám ezeken az oldalakon, és mennyire bízhat benne.
A két gyűjtőoldal
| Gyűjtőoldal | Szekciók | Adatpontok | Források | Frissítve |
|---|---|---|---|---|
| AI-ügynök statisztikák | elterjedés · ROI · fejlesztők · képességek · megbízhatóság · munkaerő | 92 | 21 | 2026-09-13 |
| AI-kódolóeszköz-statisztikák | elterjedés · termelékenység · minőség · benchmarkok · ügynökök · munkaerő | 91 | 26 | 2026-09-13 |
Minden adat egy sorszámozott forrásbejegyzésre mutat. A bejegyzés rögzíti a kiadót, a jelentés nevét és a dátumot. A dátum a forrás mérésének vagy megjelenésének ideje, nem az oldal frissítésének napja. Egy 2025 közepén végzett felmérés 2025-ös címkével marad, függetlenül attól, milyen nemrég frissítették az oldalt.
Mi egy szám a gyűjtőoldalon, és mi nem
A gyűjtőoldalak szándékosan háromféle bizonyítékot tesznek ugyanarra az oldalra. Ezek nem ugyanazt mérik.
- "84% használ vagy tervez használni AI-eszközöket"
- számít a populáció és a lekérdezés ideje
- önbevallási torzítás
- "+19% feladatidő egy RCT-ben"
- számít a minta és a feladatsor
- korlátozott általánosíthatóság
- "61.5% a SWE-bench Pro-n"
- számít az adathalmaz verziója és a harness
- tesztadat-szennyezés kockázata
Ha egy felmérésből és egy benchmarkból származó szám ellentmondani látszik egymásnak, általában valójában nincs köztük ellentmondás. Más kérdésre felelnek. A gyűjtőoldalak külön szekciókban tartják őket, és jelölik a forrás típusát, hogy az olvasó lássa, melyik melyik.
A származtatott képletek
Mindkét gyűjtőoldalon van egy Képletek szekció. Ezek a mennyiségek az idézett adatokból vannak kiszámolva, nem egy forrásból idézzük őket. Azért szerepelnek, hogy következtetéseket lehessen levonni a számokból. Itt három példa a bemeneteikkel:
Észlelési rés (a kódolóeszközök gyűjtőoldala). A METR randomizált vizsgálatában a tapasztalt fejlesztők feladatideje 19%-kal nőtt AI használatával, miközben ők 20%-os csökkenést becsültek:
Megbízhatóság ismételt futtatások esetén (az ügynökök gyűjtőoldala). Ha egy feladat futásonként valószínűséggel sikerül, és a futások függetlenek, akkor annak a valószínűsége, hogy mind a futás során sikerül, exponenciálisan csökken. Egy benchmarkon ezeknek a feladatonkénti értékeknek az átlaga a mérőszám, nem az összesített sikerarány -adik hatványa. A τ-bench pontosan ezért a -t közli: az a rendszer, amely egy feladatot nagyjából az esetek felében old meg, megbízhatósága jóval 50% alá csökken, ha ugyanannak a feladatnak nyolcszor egymás után kell sikerülnie.
Kódellenőrzési terhelés szorzója (a kódolóeszközök gyűjtőoldala). A Faros telemetriája szerint a sokat AI-t használó csapatok 98%-kal több pull requestet mergelnek, és mindegyik 154%-kal nagyobb:
Minden képletkártya megnevezi azt a feltevést, amely korlátozza az érvényességét. A kódellenőrzési szorzónál ez az, hogy mindkét hatás ugyanazokra a csapatokra vonatkozik. A -nál az, hogy ugyanannak a feladatnak a futásai függetlenek.
A szószedet
A szószedet 82 fogalomoldalt tartalmaz, két témakörből generálva: 41 ügynök-fogalomból és 49 kódolóeszköz-fogalomból. Nyolc slug mindkét halmazban szerepel. Ilyen a kontextusablak, az MCP, a kódoló ügynök, a SWE-bench, a benchmark-telítődés és még három. Ezek egyetlen URL-re és egyetlen definícióra oldódnak fel, és az oldal feltünteti, hogy a fogalom mindkét témakörhöz tartozik. Nincs két versengő bejegyzés.
Minden fogalomoldal tartalmaz egy egymondatos definíciót, egy hosszabb magyarázatot, és linkeket azokra a statisztikákra, amelyek használják a fogalmat. Az egymondatos definíció a mérvadó. A statisztikai gyűjtőoldalak és az összehasonlító oldalak a fogalmakat ebben az értelemben használják.
Hivatkozás
A gyűjtőoldalak CC BY 4.0 licenc alatt jelennek meg, minden oldal alján egy BibTeX-bejegyzéssel, és a forrástáblát strukturált adatként is elérhetővé teszik. Az adatnál az elsődleges forrásra, az összeállításnál pedig a gyűjtőoldalra hivatkozz. Ha egy gyűjtőoldalról származó szám forrás nélkül szerepel, az másodlagos hivatkozás.
Arra, hogyan kerül módszertan egyetlen kiemelt számhoz, a Terminal-Bench 2.1 módszertan ad részletes példát.