
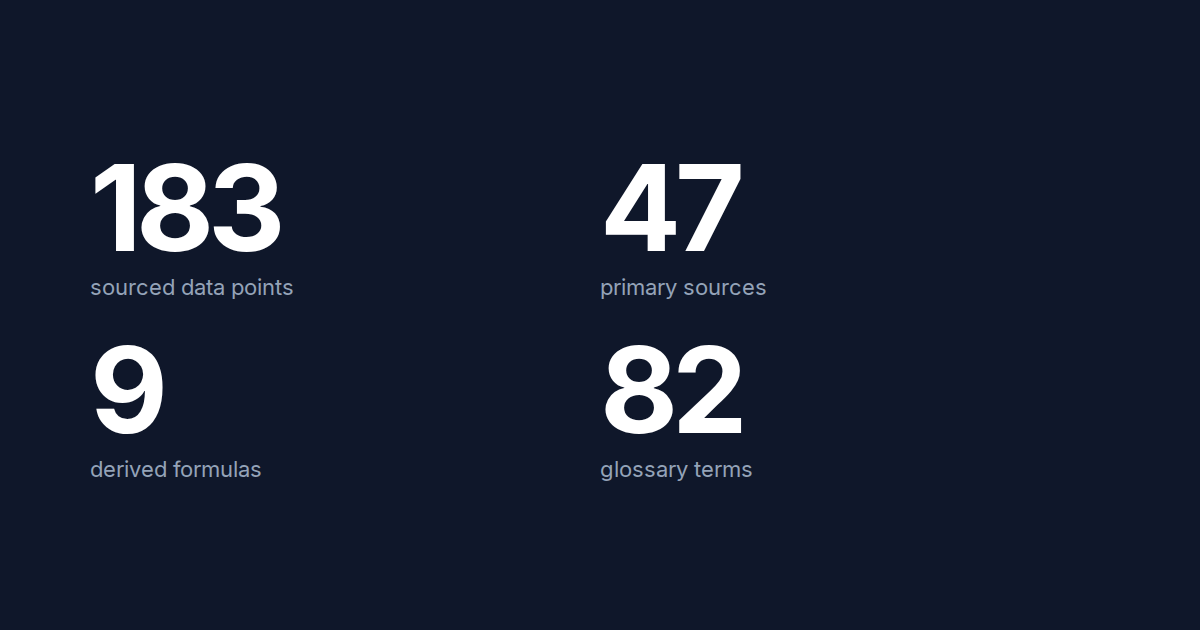
Drei Referenzseiten stehen außerhalb des chronologischen Feeds. Sie werden gepflegt statt datiert: zwei Statistik-Hubs und ein Glossar. Dieser Beitrag beschreibt, wie sie aufgebaut sind. So weißt du, was eine Zahl dort bedeutet und wie weit du ihr trauen kannst.
Die zwei Hubs
| Hub | Bereiche | Datenpunkte | Quellen | Aktualisiert |
|---|---|---|---|---|
| KI-Agenten-Statistiken | Verbreitung · ROI · Entwickler · Fähigkeiten · Zuverlässigkeit · Arbeitswelt | 92 | 21 | 2026-09-13 |
| KI-Coding-Tool-Statistiken | Verbreitung · Produktivität · Qualität · Benchmarks · Agenten · Arbeitswelt | 91 | 26 | 2026-09-13 |
Jede Zahl verlinkt auf einen nummerierten Quelleneintrag. Er nennt Herausgeber, Berichtsname und Datum. Das Datum ist das Mess- oder Veröffentlichungsdatum der Quelle, nicht das Datum der Hub-Aktualisierung. Eine Umfrage von Mitte 2025 bleibt mit 2025 beschriftet, egal wie frisch die Seite ist.
Was eine Zahl im Hub ist – und was nicht
Die Hubs zeigen bewusst drei Arten von Belegen auf derselben Seite. Sie messen nicht dasselbe.
- „84% nutzen KI-Tools oder planen es“
- Grundgesamtheit und Erhebungszeitpunkt sind relevant
- Verzerrung durch Selbstauskunft
- „+19% Aufgabenzeit in einer RCT“
- Stichprobe und Aufgabenset zählen
- nur begrenzt verallgemeinerbar
- „61.5% auf SWE-bench Pro“
- Dataset-Version und Harness zählen
- Kontaminationsrisiko
Eine Umfragezahl und eine Benchmarkzahl, die sich zu widersprechen scheinen, tun das meist nicht. Sie beantworten verschiedene Fragen. Die Hubs halten sie in getrennten Bereichen und kennzeichnen den Quellentyp. So siehst du, was was ist.
Die abgeleiteten Formeln
Jeder Hub hat einen Bereich Formeln mit Größen, die aus den zitierten Zahlen berechnet sind, nicht aus einer Quelle übernommen. Sie sind da, damit man mit den Zahlen rechnen und argumentieren kann. Drei Beispiele, mit ihren Eingaben:
Wahrnehmungslücke (Coding-Tools-Hub). METRs randomisierte Studie maß bei erfahrenen Entwicklern Aufgabenzeit mit KI, während sie selbst schätzten:
Zuverlässigkeit bei Wiederholung (Agenten-Hub). Gelingt eine einzelne Aufgabe pro unabhängigem Durchlauf mit der Wahrscheinlichkeit , sinkt die Wahrscheinlichkeit, dass sie in allen Durchläufen gelingt, geometrisch. Über einen Benchmark hinweg ist die Kennzahl der Durchschnitt dieser Einzelwerte, nicht die aggregierte Erfolgsquote hoch . τ-bench gibt genau aus diesem Grund an: Ein System, das eine Aufgabe etwa in der Hälfte der Fälle löst, ist deutlich weniger als halb so zuverlässig, wenn dieselbe Aufgabe achtmal hintereinander gelingen muss.
Review-Last-Multiplikator (Coding-Tools-Hub). Faros-Telemetrie zeigt: Teams mit hoher KI-Nutzung mergen 98% mehr Pull Requests, jeder davon 154% größer:
Jede Formelkarte nennt die Annahme, die sie begrenzt. Beim Review-Last-Multiplikator ist es, dass beide Effekte dieselben Teams betreffen. Bei ist es, dass Durchläufe derselben Aufgabe unabhängig sind.
Das Glossar
Das Glossar hat 82 Begriffsseiten, erzeugt aus zwei Themensets: 41 Agenten-Begriffe und 49 Coding-Tool-Begriffe. Acht Slugs kommen in beiden Sets vor – context window, MCP, coding agent, SWE-bench, benchmark saturation und drei weitere. Statt zwei konkurrierende Einträge zu erzeugen, werden sie unter einer gemeinsamen URL und Definition zusammengeführt; die Seite führt beide Themenset-Zugehörigkeiten auf.
Jede Begriffsseite hat eine Definition in einem Satz, eine längere Erklärung und Links zurück zu den Statistiken, die den Begriff verwenden. Die Definition in einem Satz ist die maßgebliche. Die Statistik-Hubs und die Vergleichsseiten verwenden die Begriffe in diesem Sinn.
Zitieren
Die Hubs stehen unter CC BY 4.0. Am Ende jeder Seite steht ein BibTeX-Eintrag, und die Quellentabelle liegt als strukturierte Daten vor. Zitiere die Primärquelle für die Zahl und den Hub für die Zusammenstellung. Eine Zahl aus dem Hub ohne Verweis auf die zugehörige Primärquelle ist ein Sekundärzitat.
Ein Beispiel dafür, wie die Methodik einer einzelnen zentralen Kennzahl dokumentiert wird, findest du in der Terminal-Bench 2.1 Methodik.