
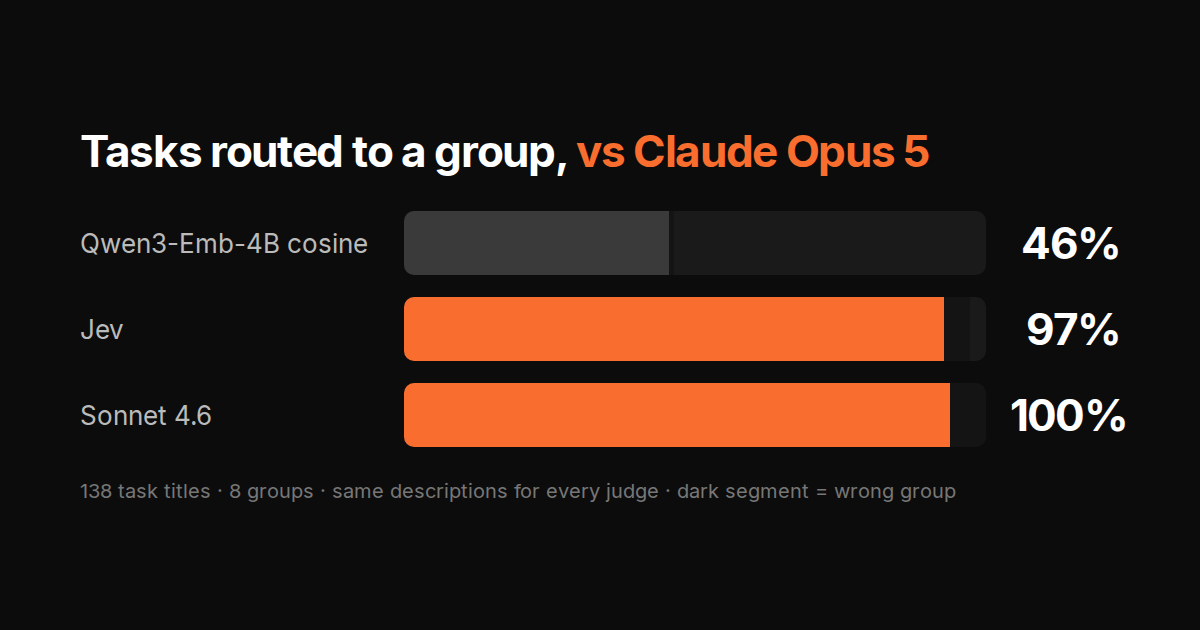
A feladatcím és a csoportleírás közötti koszinusz-hasonlóság nem osztályozó.
Benchmark, esetek, nyers ítéletek: backend/bench/categorization a TODOforAI repóban. Teljes
költség ~$0.50.
Felállás
A TODOforAI táblákon csoportok vannak (SEO, Paid, Frontend…); az új feladatok kapnak
egy javasolt csoportot. V1: beágyazom a címet, valamint a csoport nevét + leírását, a
legnagyobb koszinusz-hasonlóságú csoport nyer. Embedder: Qwen/Qwen3-Embedding-4B DeepInfrán keresztül, 512
dimenzió, egységnormájúra normalizálva, lekérdezési utasítás: “Given a task, retrieve the
workstream whose purpose best matches the task”. Tartózkodik, ha a legjobb < 0.50, vagy a
második helyezettel a különbség < 0.06.
100%-os precizitás 18 kézzel összeállított teszteseten. A valódi táblám nagy része Unsorted-ban maradt.
Bírák
Ugyanaz a 138 cím, ugyanaz a 8 csoport, ugyanaz a leírásszöveg, példafeladatok nélkül —
pontosan az, amit az éles rendszer lát. A címek valódi todókhoz hasonlóak: rövidek, fele
magyar, 15 értelmetlen (call mom, asdf), 5 kétértelmű.
- embedding — az éles verzió, változatlanul
- jev — TypeSafe Jev, nem autoregresszív
döntési modell a Vercel AI Gateway-en. Egy
choicekérdés, 8 csoport +none. $0.04/MTok bemenet, a kimenet ingyenes. - sonnet — Claude Sonnet 4.6, temp 0, egy slug vagy
none - opus — Claude Opus 5, ugyanaz a prompt. Az igazság. Az én címkéim csak még egy vélemény.
Csapda: az Opus 5 válasz előtt gondolkodik; a max_tokens: 20 mellett úgy tűnt, mintha
88/138 esetben tartózkodna. Adj neki 400-at.
Számok
| Bíró | egyezik az Opusszal | rossz csoport | kihagyott | 138 feladat |
|---|---|---|---|---|
| embedding | 77/138 | 1 | 60/112 | 8 s |
| jev | 130/138 | 5 | 3/112 | 24 s |
| sonnet 4.6 | 131/138 | 7 | 0/112 | 57 s |
Az Opus 112-t sorolt be, 26-ra none-t mondott (15 értelmetlen + 11 homályos). Embedding:
egyszer tévedett, 54%-ot kihagyott. Jev: 97% besorolva, 5 rossz. A Sonnet 7 eltérő
besorolásánál nem egyértelmű, neki vagy az Opusnak van-e igaza. A valódi táblámon a Jev és
az Opus 21/26-ban egyezik.
Miért tartózkodik az embedding
Nem a különbségi küszöb miatt:
                         agree   wrong   missed
margin 0.06  floor 0.50    76      2       60     ← production
margin 0     floor 0.50    79     41       18
margin 0     floor 0       76     62        0
Ha elhagyod a küszöbfeltételt, az eddig Unsortedban maradó feladatok rossz csoportba kerülnek. A top-1 a feladatok ~45%-ánál téves.
bun test flaky on CI          frontend 0.540   development 0.537
call mom                      email 0.540      plg 0.525
asdf                          development 0.663  frontend 0.659
A pontszámok 0.42–0.72 között mozognak; az asdf többet kap, mint egy valódi feladat, így
semmilyen alsó küszöb nem szűri ki az értelmetlent. A Frontend/Development, Paid/SEO,
Enterprise/Paid átfed, ezért a valódi feladatok bármilyen különbségi küszöbön belülre esnek.
A Jev és az LLM-ek értik a kívánt eredményt: egy CI-hiba azért Development, mert a kijavításával elért eredmény ennek a csoportnak a céljához illik.
A hasonlóság ezt nem tudja megmondani.
Mi ment élesbe
A Jev sorol be; az embedding a tartalék, ha a gateway nincs beállítva vagy nem elérhető.
25-ös kötegekben dolgozik, a none külön válaszlehetőség, és ≥ 0,5-ös valószínűségnél fogadjuk el a besorolást. ~0.3 s feladatonként.
Nem Sonnet: 57 s a 24 s helyett és ~100-szoros ár, egy olyan javaslatért, ami 400 ms-mal azután jön, hogy abbahagyod a gépelést.
| Router | 1000 feladatra | 1M feladatra |
|---|---|---|
| embedding (~15 tok, $0.01/MTok) | $0.0002 | $0.15 |
| jev (kérdésenként ~260 tokenes katalógus, $0.04/MTok bemenet, kimenet ingyenes) | $0.01 | $10 |
| sonnet 4.6 (~350 be / 10 ki) | $1.20 | $1,200 |
| opus 5 (~350 be / ~200 ki gondolkodással) | $7 | $7,000 |
Listaárak, 8 csoport. A Jev ~70-szer annyiba kerül, mint az embedding, és kétszer annyit sorol be.
A Jev öt hibája a csatorna és az eredmény összekeveréséből adódik (sponsor a newsletter, measure signups → email, nem
paid). Tévedéskor alacsonyabb a magabiztosság (0.70 vs 0.94), de a 0.6-os küszöb 2 rossz
helyett 7 Unsortedet ad. Maradunk az 5-nél.
Tanulságok
- A precizitás önmagában hazudik. Jelenítsd meg a recallt valamihez képest, amiben megbízol.
- Erős modellhez mérj, ne a saját címkéidhez.
- Ellenőrizd a referencia kimeneti keretét. A csonkolt válasz óvatosnak látszik.
A 138 eset kevés. Elég ahhoz, hogy látsszon az 54%-os recall-rés; csak ennyit állítok.