
Kosinusähnlichkeit zwischen Task-Titel und Gruppenbeschreibung ist kein Klassifikator.
Benchmark, Testfälle, Rohurteile: backend/bench/categorization im TODOforAI-Repo. Gesamtkosten ~$0.50.
Setup
TODOforAI-Boards haben Gruppen (SEO, Paid, Frontend…). Neue Tasks bekommen einen Gruppenvorschlag. V1: Titel und Gruppenname + Beschreibung einbetten, die Gruppe mit der höchsten Kosinusähnlichkeit gewinnt. Embedder Qwen/Qwen3-Embedding-4B über DeepInfra, 512 Dims, unit-normalized, Query-Instruction “Given a task, retrieve the workstream whose purpose best matches the task”. Enthaltung, wenn best < 0.50 oder Margin zum Zweitplatzierten < 0.06.
100% Precision bei 18 manuell erstellten Testfällen. Der Großteil meines echten Boards landete in Unsorted.
Judges
Dieselben 138 Titel, dieselben 8 Gruppen, derselbe Beschreibungstext, keine Beispiel-Tasks – genau das, was Production sieht. Die Titel sind wie echte Todos geschrieben: kurz, halb auf Ungarisch, 15 Unsinn (call mom, asdf), 5 mehrdeutig.
- embedding — Production, unverändert
- jev — TypeSafe Jev, nicht-autoregressives Entscheidungsmodell im Vercel AI Gateway. Eine
choice-Frage, 8 Gruppen +none. $0.04/MTok Input, Output kostenlos. - sonnet — Claude Sonnet 4.6, Temp 0, ein Slug oder
none - opus — Claude Opus 5, gleicher Prompt. Die Wahrheit. Meine Labels sind nur eine weitere Meinung.
Falle: Opus 5 überlegt vor der Antwort. Mit max_tokens: 20 sah es bei 88/138 so aus, als würde es sich enthalten. Gib ihm 400.
Zahlen
| Judge | stimmt mit Opus überein | falsche Gruppe | nicht zugeordnet | 138 Tasks |
|---|---|---|---|---|
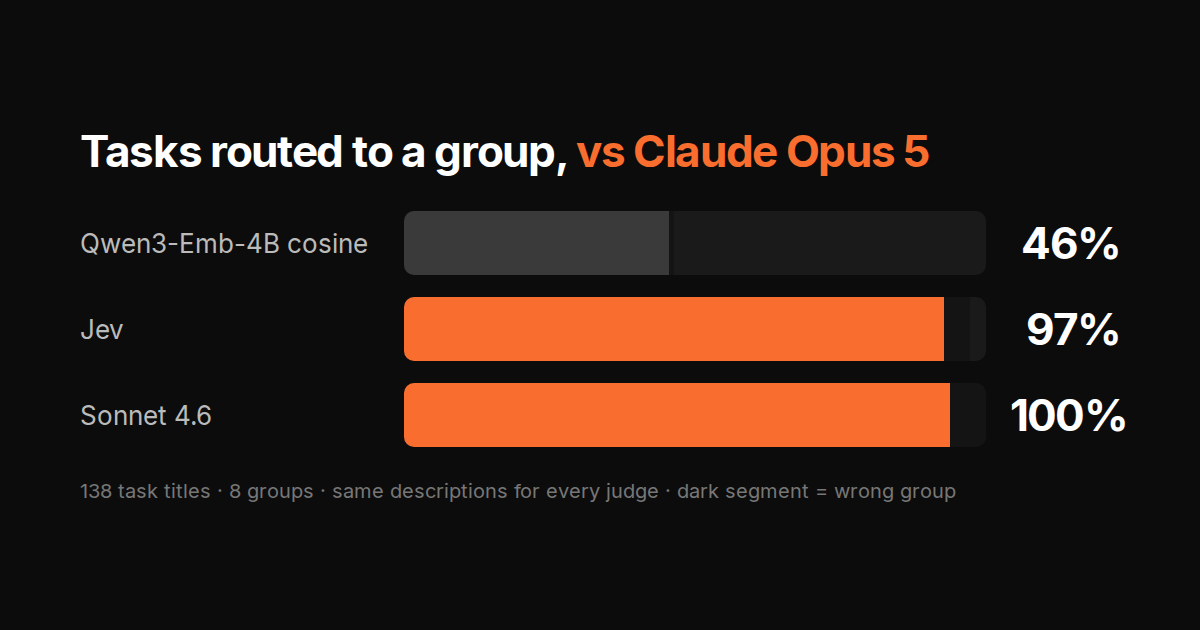
| embedding | 77/138 | 1 | 60/112 | 8 s |
| jev | 130/138 | 5 | 3/112 | 24 s |
| sonnet 4.6 | 131/138 | 7 | 0/112 | 57 s |
Opus hat 112 zugeordnet und bei 26 none gesagt (15 Unsinn + 11 vage). Embedding: einmal falsch, 54 % nicht zugeordnet. Jev: 97% zugeordnet, 5 falsch. Die 7 Fehlzuordnungen von Sonnet sind gegenüber Opus reine Ermessensfragen. Auf meinem echten Board sind sich Jev und Opus bei 21/26 einig.
Warum das Embedding sich enthält
Nicht die Margin:
                         agree   wrong   missed
margin 0.06  floor 0.50    76      2       60     ← production
margin 0     floor 0.50    79     41       18
margin 0     floor 0       76     62        0
Ohne Gate wird aus Unsorted die falsche Gruppe. Top-1 ist bei ~45% der Tasks falsch.
bun test flaky on CI          frontend 0.540   development 0.537
call mom                      email 0.540      plg 0.525
asdf                          development 0.663  frontend 0.659
Die Scores liegen zwischen 0.42 und 0.72. asdf schlägt einen echten Task, also findet kein Floor den Unsinn. Frontend/Development, Paid/SEO und Enterprise/Paid überlappen, also sind bei echten Tasks die Abstände für jeden sinnvollen Margin-Schwellwert zu klein. Jev und die LLMs kennen Ergebnisse: Ein CI-Flake gehört zu Development, weil entscheidend ist, welches Ergebnis seine Behebung erzielt. Similarity kann das nicht sagen.
Was live gegangen ist
Jev routet. Das Embedding ist der Fallback, wenn das Gateway nicht konfiguriert oder nicht erreichbar ist. Batches à 25, none explizit, Wahrscheinlichkeit ≥ 0.5 wird akzeptiert. ~0.3 s pro Task.
Nicht Sonnet: 57 s vs. 24 s bei einem ~100-mal so hohen Preis – für einen Vorschlag 400 ms nachdem du aufgehört hast zu tippen.
| Router | pro 1.000 Tasks | pro 1M Tasks |
|---|---|---|
| embedding (~15 tok, $0.01/MTok) | $0.0002 | $0.15 |
| jev (~260 tok Katalog pro Frage, $0.04/MTok In, Out kostenlos) | $0.01 | $10 |
| sonnet 4.6 (~350 in / 10 out) | $1.20 | $1,200 |
| opus 5 (~350 in / ~200 out mit Reasoning) | $7 | $7,000 |
Listenpreise, 8 Gruppen. Jev kostet ~70× so viel wie das Embedding und routet doppelt so viele Tasks.
Die 5 Fehlzuordnungen von Jev sind Kanal-vs-Ergebnis-Fälle (sponsor a newsletter, measure signups → email, nicht paid). Die Confidence ist bei Fehlern niedriger (0.70 vs 0.94), aber ein Floor von 0.6 tauscht 2 Fehlzuordnungen gegen 7 Unsorted. Wir behalten die 5.
Takeaways
- Precision allein lügt. Zeig Recall gegen etwas, dem du vertraust.
- Vergleiche mit einem starken Modell, nicht gegen deine eigenen Labels.
- Prüf das Output-Budget der Referenz. Ein abgeschnittener Output wirkt wie vorsichtige Zurückhaltung.
138 Cases sind wenig. Es reicht, um eine Recall-Lücke von 54% zu sehen. Das ist die einzige Behauptung.